 Kanada Kurniawan
Prasyarat: Bab 1 (tensor, konsep ML/DL). Kode memakai TensorFlow/Keras di Google Colab (Bab 1: setup lingkungan). Jika Anda sudah paham regresi linear dan pernah menulis
Denselayer, Anda boleh lompat cepat ke Bagian 2.5, tetapi pastikan Anda tahu istilah bobot, bias, dan fungsi aktivasi.
Catatan: Materi bab ini adalah materi pengenalan, bukan hasil riset baru. Seluruh isi merupakan ringkasan ulang literatur machine learning, dengan contoh-contoh yang dekat dengan dunia meteorologi Indonesia.
Tujuan Pembelajaran
Setelah menyelesaikan bab ini, Anda diharapkan mampu:
- Membangun model regresi neural network (perceptron/MLP) untuk prediksi besaran meteorologi dengan TensorFlow/Keras.
- Menjelaskan peran bobot, bias, dan fungsi aktivasi (termasuk ReLU) serta kapan non-linearitas diperlukan.
- Menerapkan mini-kasus pasang surut: windowing, baseline persistence, dan perbandingan MAE antara model neural vs baseline.
- Memilih antara MAE dan MSE berdasarkan sifat data dan tujuan, serta membagi data deret waktu secara kronologis yang mencegah leakage.
2.1 Prediksi Besaran sebagai Masalah Regresi
Banyak pertanyaan meteorologi yang jawabannya berupa angka:
- Berapa suhu maksimum besok di Pontianak?
- Berapa milimeter hujan pada hari Jumat mendatang?
- Berapa tinggi pasang surut pada pukul 18.00 nanti?
- Berapa kecepatan angin maksimum saat badai lewat?
Masalah seperti ini disebut regresi - memprediksi nilai kontinu dari pola di data.
Kata “kontinu” penting: keluarannya adalah bilangan nyata (mis. 26.5°C, 34 mm), bukan
kategori. Ini kontras dengan klasifikasi (Bab 3) yang memprediksi label, misalnya
“hujan” atau “tidak hujan”.
Mengapa regresi sering menjadi tempat pertama belajar neural network? Karena cara kerja neuronnya sama persis dengan klasifikasi; perbedaannya hanya di bagian ujung: lapisan keluaran dan fungsi loss yang dipakai. Jika Anda menguasai regresi, setengah jalan menuju klasifikasi sudah terlewati.
Ada jenis pertanyaan yang terlihat seperti angka tetapi sebenarnya bukan regresi. Misalnya “berapa hari hujan bulan depan?” - satu angka, memang, tetapi pertanyaan ini lebih baik diperlakukan sebagai masalah count atau dibentuk ulang sebagai deret waktu bulanan. Contoh yang jelas bukan regresi: “apakah akan berpotensi banjir?” - ini klasifikasi (ya/tidak). Bab 1 Bagian 1.8 sudah melatih Anda membedakan keduanya; di Bab 2 kita fokus pada regresi sungguhan.
Contoh target regresi dalam meteorologi
Tabel 2.1: Contoh target regresi meteorologi, satuan, dan sifat datanya.
| Target | Satuan | Sifat data |
|---|---|---|
| Suhu udara (maks/min) | °C | Relatif mulus, distribusi simetris |
| Curah hujan | mm | Ekor kanan, banyak nol, jarang sangat besar |
| Tinggi pasang surut | m | Periodik, deterministik kuat |
| Kecepatan angin | m/s | Berdenyut, tergantung musim/lokal |
Tabel 2.1 (diperluas di Bab 6) menunjukkan bahwa “regresi meteo” bukan satu jenis data yang sama: hujan berbeda jauh dari suhu. Pilihan loss, metrik, dan arsitektur model akan tergantung pada sifat ini (kita bahas di Bagian 2.6).
2.2 Anatomi Neuron: Bobot, Bias, dan Fungsi Aktivasi
Neuron buatan (artificial neuron) adalah unit dasar jaringan saraf. Ia menerima beberapa
masukan x, mengalikan tiap masukan dengan bobot w, menjumlahkannya, lalu
menambahkan bias b:
Hasilnya “diaktifkan” oleh fungsi aktivasi f, menghasilkan keluaran:
Bobot w mencerminkan seberapa penting tiap masukan; bias b adalah “ambang” yang
memungkinkan neuron aktif bahkan ketika semua masukan nol. Keduanya adalah parameter yang
dipelajari dari data selama pelatihan (Bab 4). Saat awal, nilainya acak kecil; melalui
ribuan contoh, model menyesuaikan bobot agar prediksinya semakin akurat.
Contoh paling sederhana adalah perceptron yang diperkenalkan Rosenblatt pada 1958 [1]:
neuron dengan fungsi aktivasi berbentuk aturan - misalnya a = 1 jika z > 0, dan a = 0
sebaliknya. Perceptron historis penting karena menunjukkan bahwa mesin bisa belajar, tetapi
terbatas pada masalah yang linearly separable. Di Bab 2 ini kita menggunakan versi modern:
neuron tanpa aktivasi di lapisan keluaran untuk regresi (nilai bebas, bukan 0/1).
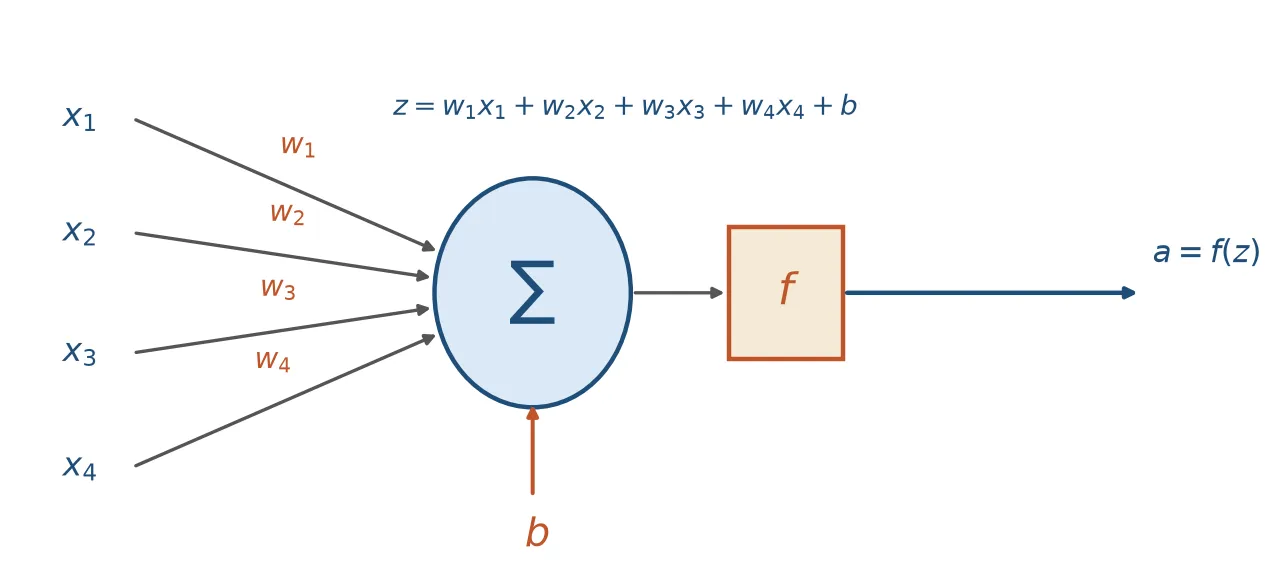
Gambar 2.1: Struktur neuron buatan: masukan x dikalikan bobot w, dijumlahkan
dengan bias b, lalu melalui fungsi aktivasi f menghasilkan keluaran a.
Persamaan (2.1) dan (2.2) diilustrasikan pada Gambar 2.1: setiap panah masukan membawa
satu komponen x_i yang dikalikan w_i; semua hasil dijumlahkan bersama bias menjadi
z (nilai sebelum aktivasi); lalu f menghasilkan keluaran a.
Contoh numerik sederhana
Misalkan kita memprediksi suhu minimum besok (y) dari dua variabel: suhu hari ini
(x₁ = 26) dan kelembapan (x₂ = 90%). Jika bobot w₁ = 0.5, w₂ = -0.05, dan bias b = 10, maka:
Tanpa fungsi aktivasi (identitas), prediksi ŷ = 18.5°C. Pembaca bisa melihat intuisi:
suhu hari ini menaikkan prediksi (bobot positif), kelembapan tinggi menurunkannya (bobot
negatif). Tugas pelatihan justru menemukan w dan b yang “paling masuk akal” ini dari
data - bukan menentukannya manual.
2.3 Satu Neuron Linear = Regresi Linear
Sebuah neuron tanpa fungsi aktivasi (identitas) untuk satu masukan:
Persamaan (2.3) identik dengan regresi linear yang biasa Anda pelajari di statistika. Bedanya hanya di jalur penemuan parameter:
- Statistika klasik:
wdanbdihitung dengan rumus kuadrat terkecil (closed-form). - Neural network:
wdanbditemukan lewat proses berulang (gradient descent, Bab 4).
Hasil akhirnya sama - dalam kondisi dasar: fungsi loss MSE, tanpa regularisasi, dan pelatihan yang konvergen ke minimum global (regresi linear konveks, sehingga GD mencapai solusi OLS). Jika Anda ganti loss ke MAE, menambahkan regularisasi L1/L2, atau menghentikan pelatihan lebih awal (early stopping), hasilnya akan berbeda dari solusi closed-form. Catatan ini penting: “sama” berlaku hanya untuk kasus dasar di Kode 2.2-2.3. Karena itu, satu neuron linear sebaiknya dianggap sebagai baseline - bukan “neural network yang mengesankan”. Prinsip di Bab 1 tetap berlaku: mulai dari model paling sederhana, ukur kinerjanya, lalu tingkatkan jika perlu.
Mengapa kita tetap mempelajari regresi linear di buku deep learning? Tiga alasan:
- Interpretasi:
wmemiliki arti langsung (“kenaikan satu unit x menaikkan y sebesar w”). Ini sangat berharga di meteorologi, di mana rekan kerja bertanya “kenapa model bilang begini?”. - Baseline wajib: hampir semua Bab 8-9 membandingkan LSTM/MLP dengan baseline linear. Tanpa memahami baseline, kita tidak bisa menilai “apakah DL benar-benar menambah nilai?”.
- Blok bangunan: regresi linear adalah neuron tunggal; jaringan saraf adalah kumpulan neuron yang dihubungkan. Semua konsep (bobot, bias, loss) muncul di sini.
Mulai dari model ini dulu sebelum menambah lapisan - prinsip “mulai sederhana, lalu tingkatkan” yang akan menemani sepanjang buku.
2.4 Kebutuhan Non-linearitas: Perkenalan ReLU
Data meteorologi jarang linear sempurna. Hubungan antara variabel seperti kelembapan, suhu, dan curah hujan tidak bisa diwakili hanya oleh garis lurus: hujan tidak meningkat terus-menerus seiring kelembapan; ada ambang, jenuh, dan interaksi. Contoh sederhana: hubungan suhu dan laju penguapan mungkin kurva, bukan garis.
Masalahnya: jika kita menyusun beberapa neuron linear berlapis, seluruh jaringan tetap
linear - karena jumlah fungsi linear adalah fungsi linear. Komposisi linear(linear(x))
tidak menghasilkan kemampuan baru: seberapa dalam pun, model tetap “garis lurus” dalam ruang
berdimensi banyak.
Agar model mampu menangkap pola non-linear, setiap lapisan menyisipkan fungsi aktivasi non-linear. Fungsi yang paling umum sekarang adalah ReLU (rectified linear unit):
ReLU mengeluarkan nilai masukan jika positif, dan nol jika negatif (persamaan (2.4)). Sederhana, murah dihitung (satu perbandingan), dan menjadi komponen dasar banyak jaringan modern [2]. Referensi ini merujuk pada AlexNet (2012), jaringan yang mempopulerkan ReLU dalam kompetisi ImageNet; relevansinya di sini adalah peran ReLU dalam sejarah arsitektur modern, bukan karena bab ini memprediksi gambar. ReLU juga menghindari beberapa masalah gradien yang dimiliki sigmoid/tanh (Bab 4 membahas topik ini lebih dalam).
Dari neuron ke MLP
MLP (multi-layer perceptron) adalah jaringan dengan satu lapisan masukan, satu atau lebih lapisan tersembunyi (masing-masing dengan fungsi aktivasi non-linear), dan lapisan keluaran. Untuk regresi, lapisan keluaran tidak memakai aktivasi - kita ingin nilai bebas, bukan dibatasi ke rentang tertentu.
Contoh arsitektur MLP untuk memprediksi suhu besok dari suhu kemarin:
Input: suhu-1 hari sebelumnya
  → Dense(8, activation='relu')
  → Dense(8, activation='relu')
  → Dense(1)  # regresi, tanpa aktivasi
Kode 2.1 - Definisi arsitektur MLP regresi dengan Keras.
import tensorflow as tf

model = tf.keras.Sequential([
    tf.keras.layers.Dense(8, activation="relu", input_shape=(1,)),
    tf.keras.layers.Dense(8, activation="relu"),
    tf.keras.layers.Dense(1),
])
print(model.summary())
Kode 2.1 memakai dua lapisan Dense berisi 8 neuron dengan ReLU, lalu satu neuron keluaran.
input_shape=(1,) menandakan satu fitur per sampel. Jumlah neuron (8) adalah contoh;
Anda bisa mengubahnya - bukan angka ajaib, melainkan keputusan desain (tuningnya dibahas
di Bab 4).
Berapa banyak lapisan? Intuisi bukan rumus
Aturan praktis soal “berapa dalam”: mulai cukup kecil, tambah kompleksitas hanya bila
perlu dan data cukup. Untuk regresi deret waktu stasiun dengan data jam-jaman
(ratusan ribu hingga jutaan baris; data harian 100 tahun hanya ~36.500 baris),
1-3 lapisan Dense sudah sering cukup. Model yang terlalu besar akan overfit
(Bab 5) - menghafal data latih dan gagal di data baru.
ReLU dan variannya (sekilas)
ReLU sederhana dan efektif, tetapi punya satu kelemahan: untuk masukan negatif, keluarannya persis nol dan gradiennya juga nol. Neuron yang “mati” (selalu memberi nol) tidak ikut belajar lagi - fenomena ini disebut dying ReLU. Dalam praktik ringan (regresi sederhana, jaringan kecil) masalah ini jarang fatal, tetapi di jaringan yang dalam bisa muncul.
Beberapa varian yang sering dipakai sebagai pengganti:
- Leaky ReLU:
max(0.01x, x)- memberi kemiringan kecil untuk nilai negatif sehingga neuron tidak pernah sepenuhnya mati. - ELU: versi mulus dengan perilaku asimtotik untuk nilai sangat negatif.
- tanh dan sigmoid: fungsi S-kurva yang lebih tua; relevan untuk klasifikasi (Bab 3) dan beberapa kasus.
Untuk Bab 2-9, ReLU (atau Leaky ReLU) adalah pilihan default yang aman untuk lapisan tersembunyi. Anda tidak perlu menghafal semua varian sekarang; yang penting memahami mengapa non-linearitas dibutuhkan dan bahwa ada beberapa pilihan dengan trade-off.
2.5 Mini-Kasus: Memprediksi Tinggi Pasang Surut Sederhana
Sebagai identitas “data laut Indonesia” sesuai strategi umum buku, kita mulai dengan contoh kecil: data pasang surut. Pasang surut bersifat periodik - sebagian besar perairan Indonesia bertipe semi-diurnal atau diurnal campuran [3] - sehingga cocok untuk regresi sederhana: ada pola yang bisa dipelajari, cukup deterministik.
Pendekatan paling dasar: memprediksi tinggi air besok berdasarkan tinggi air hari ini dan kemarin (dua fitur). Ini contoh autoregressive: target (besok) dijelaskan oleh nilai-nilai sebelumnya. Data nyata pasang surut akan dibahas penuh di Bab 8; di sini kita mengenalkan alurnya saja:
input: [tinggi(t-2), tinggi(t-1)] → Dense+ReLU → output: tinggi(t)Langkah 1 - Bentuk data (windowing)
Data deret waktu tinggi(t) (jam demi jam) diubah menjadi kumpulan pasangan fitur-target
dengan window dua langkah. Setiap baris contoh:
| contoh | fitur [x1, x2] = [t-2, t-1] | target y (t) |
|---|---|---|
| 1 | [0.95, 1.02] | 0.98 |
| 2 | [1.02, 0.98] | 1.05 |
| 3 | [0.98, 1.05] | 1.12 |
Tabel 2.2: Contoh windowing dua langkah pada deret tinggi pasang surut (nilai ilustratif).
Urutan fitur di tabel cocok dengan Kode 2.2: kolom pertama [t-2], kolom kedua [t-1].
Cara membangun windowing ini dijelaskan di Bab 7 secara mendalam; di Bab 2 kita cukup memakai bentuk tabel di atas sebagai ilustrasi konsep.
Langkah 2 - Baseline dulu
Sebelum menantang neural network, ukur baseline sederhana. Untuk deret periodik seperti
pasang surut, baseline paling natural adalah persistence: “prediksi tinggi besok = tinggi
hari ini” (ŷ(t) = y(t-1)). Tabel 2.2 memberi kita patokan: berapa MAE yang dihasilkan
model yang selalu menebak nilai kemarin?
Prinsip di Bab 1 menuntut: neural network layak dipakai hanya jika mengalahkan persistence. Jika tidak, lebih baik kita memakai persistence - sederhana, tanpa pelatihan, tanpa pemeliharaan.
Langkah 3 - Latih jaringan
Kode 2.2 - Membangun windowing, split berbasis waktu, dan data sintetik pasang surut.
import numpy as np
import tensorflow as tf

np.random.seed(42)
tf.random.set_seed(42)

# data sintetik semi-diurnal (~12.42 jam) + sedikit noise
t = np.arange(0, 500)
tinggi = np.sin(2 * np.pi * t / 12.42) + 0.05 * np.random.randn(len(t))

X = np.column_stack([tinggi[:-2], tinggi[1:-1]])  # fitur: [t-2, t-1]
y = tinggi[2:]                                    # target: t

n = len(X)
n_train = int(n * 0.7)
n_val = int(n * 0.15)
X_train, y_train = X[:n_train], y[:n_train]
X_val, y_val = X[n_train:n_train+n_val], y[n_train:n_train+n_val]
X_test, y_test = X[n_train+n_val:], y[n_train+n_val:]
print(X_train.shape, X_val.shape, X_test.shape)
Kode 2.2 memperlihatkan split yang berurutan waktu: 70% pertama untuk latih, 15% berikutnya validasi, 15% terakhir uji. (Pembahasan mengapa tidak acak ada di Bagian 2.7.)
Kode 2.3 - Compile, latih, dan evaluasi model terhadap baseline persistence.
model = tf.keras.Sequential([
    tf.keras.layers.Dense(8, activation="relu", input_shape=(2,)),
    tf.keras.layers.Dense(8, activation="relu"),
    tf.keras.layers.Dense(1),
])
model.compile(optimizer="adam", loss="mse", metrics=["mae"])

history = model.fit(
    X_train, y_train,
    validation_data=(X_val, y_val),
    epochs=60, batch_size=32, verbose=0,
)

# evaluasi vs baseline persistence
pred = model.predict(X_test, verbose=0).ravel()
base_pred = X_test[:, 1]  # persistence: pakai nilai t-1 (kolom fitur ke-2)

def mae(a, b):
    return float(np.mean(np.abs(a - b)))

print("MAE persistence:", round(mae(y_test, base_pred), 4))
print("MAE neural network:", round(mae(y_test, pred), 4))
Jalankan Kode 2.3 di notebook ch-02-01_regresi_pasang_surut.ipynb. Anda akan melihat dua
angka MAE. Jika MAE jaringan lebih kecil daripada persistence, model bekerja; jika tidak,
tinjau ulang - mungkin butuh fitur lain atau arsitektur lain (Bab 7).
Interpretasi hasil, bukan hanya angka
Kadang MAE jaringan lebih kecil dari persistence tetapi tipis (misalnya 0.02 vs 0.03 m). Apakah itu berarti DL “menang”? Di Bab 5-9 kita akan membahas pertanyaan ini lebih serius: perbedaan kecil mungkin tidak signifikan secara operasional, dan biaya memelihara model harus diperhitungkan. Memiliki patokan operasional (misalnya toleransi tinggi pasang ±0.10 m) membantu menilai. Untuk menjawab “menang atau kebetulan?” secara statistik, tersedia uji seperti Diebold-Mariano yang menguji apakah perbedaan loss antara dua model signifikan, bukan hanya noise dari satu sampel uji. Di bab ini kita tidak lanjut mendalam; poinnya: angka MAE tidak cukup untuk klaim “menang” - baik konteks operasional, baik uji statistik, baik konsistensi antar-periode (Bab 5) yang diperlukan.
Kapan model “cukup baik”?
Tidak ada jawaban universal, tetapi ada tiga lensa yang berguna:
- Lensa operasional: seberapa akurat yang dibutuhkan untuk keputusan? Untuk pasang surut, pertanyaan praktisnya: “apakah selisih ini mengubah keputusan pelabuhan?” Jika MAE model jauh di bawah toleransi yang disyaratkan, model sudah cukup.
- Lensa statistik: apakah model mengalahkan baseline secara konsisten di beberapa periode uji (bukan hanya satu kali beruntung)? Latihan di Bab 5-9 memakai beberapa periode.
- Lensa pragmatis: apakah model sederhana (misal ARIMA atau persistence) sudah mencukupi? Jika ya, memakai neural network menambah biaya tanpa nilai - kembali ke prinsip Bab 1.
Tidak ada model “sempurna”; yang dicari adalah model yang cukup baik untuk tujuan dan lebih baik dari patokan sederhana. Sikap ini yang membedakan praktisi dari sekadar pengguna library.
2.6 Mengukur Kesalahan: MAE vs MSE
Setelah model menghasilkan prediksi, kita perlu mengukur seberapa salah. Dua fungsi loss regresi yang paling umum:
Tabel 2.3: Perbandingan MAE dan MSE sebagai fungsi kesalahan regresi.
| Loss | Definisi | Sifat |
|---|---|---|
| MAE (mean absolute error) | rata-rata |selisih| | Tahan terhadap pencilan; satuannya sama dengan data |
| MSE (mean squared error) | rata-rata selisih² | Memberi hukuman besar pada kesalahan besar (kuadrat) |
Di meteorologi, keduanya dipakai (Tabel 2.3); data seperti curah hujan memiliki distribusi dengan ekor kanan (kadang nilai sangat besar), sehingga pilihan loss bisa memengaruhi perilaku model. Prinsip: pilih sesuai skala & tujuan, dan selalu bandingkan dengan baseline (Bab 7).
Contoh numerik sederhana
Misalkan tiga data uji memiliki aktual y = [10, 12, 8] dan model memprediksi
ŷ = [9, 15, 8]. Selisihnya [-1, +3, 0], sehingga:
Perhatikan: satu kesalahan 3 “menyumbang” 9 ke MSE (kuadrat), jauh lebih besar daripada
kontribusinya di MAE (3). Itulah inti perbedaan: MSE lebih sensitif pada kesalahan
besar. Akar kuadrat dari MSE (RMSE) mengembalikan satuan ke data asli dan sering dipakai
sebagai metrik pelengkap.
Kapan memilih yang mana?
- Jika kesalahan besar sangat merugikan (misal prediksi pasang surut yang meleset jauh pada jam kritis), MSE/RMSE memberi penalti lebih besar - layak dipertimbangkan.
- Jika data mengandung pencilan (sensor rusak, hujan ekstrem sesekali) dan Anda tidak ingin model “dibuat sibuk” oleh satu nilai besar, MAE lebih tenang.
- Dalam praktik, banyak tim meteo melaporkan keduanya (MAE dan RMSE) karena bersama-sama memberi gambaran: MAE untuk galat khas, RMSE untuk bobot galat ekstrem.
Di Bab 5 kita tambah metrik domain (KGE, CSI, dsb.) - tetapi MAE/RMSE tetap fondasi untuk regresi.
Memahami loss sebagai “jarak” dan “hukuman”
Pandangan yang membantu: loss adalah ukuran seberapa buruk prediksi model dalam satu
angka, yang diminimalkan selama pelatihan. Ketika Anda menulis loss="mse", optimizer
menggerakkan bobot dengan tujuan memperkecil rata-rata kuadrat selisih antara aktual dan
prediksi. Bayangkan data suhu: jika model menebak 28.0°C padahal aktual 30.0°C,
selisih 2.0. MSE mengkuadratkannya menjadi 4.0 - “hukuman” lebih besar dari gabungan
dua galat 1.0 (yang hanya 2.0). Sifat ini membuat model yang dilatih dengan MSE
cenderung menghindari galat besar, kadang mengorbankan presisi pada galat kecil.
MAE tidak mengkuadratkan, sehingga semua galat diberi bobot sama. Untuk data dengan
pencilan (misal satu hari hujan ekstrem 150 mm di tengah ratusan hari 0-20 mm), model
MSE bisa “terganggu” oleh satu nilai besar itu dan memiringkan semuanya; model MAE lebih
tahan. Namun MAE memiliki gradien konstan (biasanya ±1) untuk hampir semua nilai error,
yang membuat optimasi sedikit berbeda: karena gradiennya tidak mengecil saat model
mendekati minimum, konvergensi bisa menjadi lambat atau mengoscila di sekitar solusi.
Contrast dengan MSE, yang gradiennya bervariasi dengan error (gradien kecil saat error
kecil), sehingga konvergensi lebih halus di sekitar minimum. Detail optimasi ini dibahas
di Bab 4.
Metrik versus loss
Penting membedakan dua peran:
- Loss - dipakai selama pelatihan (optimizer meminimalkannya).
- Metrik - dilaporkan kepada pembaca untuk menilai kualitas (bisa sama atau berbeda).
Di Kode 2.3 kita menggunakan loss="mse" tetapi metrics=["mae"]. Ini wajar: melatih
dengan MSE (agar galat besar dihukum) sambil melaporkan MAE (lebih mudah diinterpretasi
dalam satuan °C/m). Praktik seperti ini umum; yang penting sadar bahwa keduanya tidak harus
identik.
2.7 Adam, Learning Rate, dan Split Waktu
Setelah model dibentuk dan loss dipilih, kita melatihnya dengan optimizer. Dua istilah yang perlu dikenal sekarang:
- Adam adalah algoritma optimasi modern (turunan dari gradient descent) yang mengatur
besar langkah penyesuaian bobot per iterasi secara adaptif. Kode 2.3 memakainya cukup
dengan satu baris
optimizer="adam". Detail cara kerja & alternatifnya dibahas di Bab 4. - Learning rate mengontrol seberapa besar tiap langkah: terlalu besar → model melompat dan tidak konvergen; terlalu kecil → belajar sangat lambat. Adam sudah “cerdas” memilih ukuran langkah adaptif, tetapi nilai awal learning rate tetap perlu masuk akal (default Keras biasanya aman untuk pemula).
Kenapa split tidak boleh acak untuk data waktu?
Untuk data deret waktu meteorologi, pembagian data menjadi latih/validasi/uji harus berdasarkan waktu, bukan acak:
train (2015-2021) | validation (2022) | test (2023)Alasannya adalah leakage (kebocoran informasi). Bagi acak berarti sampel uji bisa berasal dari tanggal yang berdekatan atau di antara data latih - informasi dari masa depan “bocor” ke masa latih, sehingga performa terlihat terlalu bagus. Di dunia nyata, saat model dipakai operasional, ia hanya punya data hingga hari ini: menguji dengan data masa lalu yang dicampur acak tidak merepresentasikan kondisi itu.
Bayangkan memprediksi pasang surut besok. Jika data uji mencakup tanggal yang juga ada di data latih (hanya beda beberapa hari), model bisa “meniru” nilai tetangga. Ini bukan keterampilan prediksi masa depan - itu menyontek. Split berbasis waktu memaksa model memprediksi periode yang benar-benar belum pernah dilihat, persis seperti penggunaan nyata.
Validasi untuk tuning
Data validasi digunakan selama pelatihan untuk memantau kinerja (misalnya lewat
validation_data di Kode 2.3) dan bisa dipakai memilih hiperparameter (jumlah neuron,
learning rate). Setelah semua keputusan selesai, model diuji sekali di data test
supaya tidak curang: memakai test berkali-kali untuk menyetel model sama saja dengan
“membocorkan” test ke latihan. Bab 5 dan Bab 7 akan mengulang dan memperdalam aturan ini.
Ringkas alur mini-kasus
- Bentuk windowing (Tabel 2.2, Kode 2.2).
- Ukur baseline persistence.
- Bangun & latih MLP (Kode 2.1-2.3).
- Bandingkan MAE dengan baseline.
- Jika jaringan tidak kalah, pakai; jika sebanding, pertimbangkan biaya.
2.8 Latihan
Soal konsep
- Jelaskan perbedaan bobot dan bias pada neuron, dengan contoh variabel meteorologi.
- Mengapa MLP perlu fungsi aktivasi non-linear? Apa yang terjadi jika semua lapisan linear?
- Apa keunggulan ReLU dibanding perceptron langkah (step) untuk pelatihan?
- Data curah hujan memiliki banyak nol dan beberapa nilai sangat besar. Loss mana yang Anda pilih, MAE atau MSE, dan mengapa?
Latihan praktik (notebook ch-02-01_regresi_pasang_surut.ipynb)
- Ubah jumlah neuron pada dua lapisan
Dense(misal 4 dan 32). Catat MAE train/val/test. Kapan model mulai overfit (train jauh lebih baik daripada val)? - Tambahkan fitur ketiga
tinggi(t-3). Apakah MAE membaik? Apa alasan Anda? - Ganti
loss="mse"denganloss="mae". Bandingkan akhir MAE test. Diskusikan perbedaan. - Buat baseline kedua: rata-rata klimatologis (nilai rata-rata keseluruhan train) sebagai prediksi tetap untuk seluruh test. Bandingkan dengan persistence dan jaringan.
- Proyek mini: ambil data suhu harian stasiun lokal (misal dari GHCN-Daily - Bab 6), lakukan windowing 2 langkah, dan bandingkan MLP 2 lapisan vs persistence. Laporkan MAE.
- (Opsional, statistik) Jika punya library
statsmodelsatausklearn, ulangi perbandingan MAE model vs persistence di beberapa blok waktu dan run sekema uji Diebold-Mariano untuk menyaji apakah selisih signifikan. Bila tidak tersedia library, cukup catat MAE per blok dan diskutikan konsistensi.
Jawaban latihan tidak harus “menang”: yang penting adalah Anda terbiasa membandingkan model dengan baseline dan membaca angka MAE secara kritis - itulah sikap praktisi.
2.9 Kesalahan Umum Pemula
Beberapa jebakan yang sering muncul saat pertama kali membangun model regresi, beserta cara menghindarinya:
1. Tidak memakai baseline. Membangun MLP lalu menyimpulkan “bekerja” tanpa pernah mengukurnya terhadap persistence/linear. Solusi: selalu ukur baseline dulu (Bab 2.5).
2. Split acak untuk data waktu. Memakai train_test_split default (acak) pada deret
waktu menyebabkan leakage. Solusi: potong berurutan berdasarkan waktu (Bagian 2.7).
3. Melihat data test berulang kali. Menyetel model terhadap test sampai “jadi” adalah bentuk bocor. Solusi: simpan test untuk evaluasi akhir; pakai validasi untuk tuning (Bagian 2.7).
4. Mengubah skala tanpa menyimpan statistiknya. Jika Anda menormalisasi fitur, Anda harus menyimpan rata-rata/deviasi dari train dan menerapkannya pada test dan produksi. Menerapkan statistik dari seluruh data (termasuk test) adalah leakage. (Normalisasi dibahas di Bab 6.)
5. Melaporkan hanya loss, tanpa konteks satuan. MAE 0.02 m berarti apa? Selalu
nyatakan dengan satuan dan bandingkan dengan toleransi operasional.
6. Langsung ke arsitektur besar. Menambah banyak lapisan/neuron sebelum mencoba model kecil. Solusi: mulai kecil, tingkatkan bertahap (Bab 4).
7. Mengabaikan bentuk tensor. input_shape yang salah adalah sumber error umum.
Periksa model.summary() untuk memastikan bentuk output tiap lapisan sesuai (Kode 2.1).
Menghindari kesalahan di atas menghemat banyak waktu dan - lebih penting - menjauhkan Anda dari kesimpulan yang keliru tentang kinerja model.
Ringkasan
- Regresi = memprediksi besaran kontinu; neuron = bobot + bias + fungsi aktivasi.
- 1 neuron linear identik regresi linear; non-linearitas (ReLU) diperlukan untuk pola yang tidak lurus.
- Mini-kasus pasang surut memperkenalkan penggunaan langsung pada data laut Indonesia; baseline persistence selalu dipakai sebagai pembanding.
- MAE vs MSE: pilih sesuai skala & tujuan; Adam & learning rate; split berbasis waktu untuk melawan leakage.
- Proyek ML selalu: bentuk data → baseline → model → bandingkan → putuskan.
References
- F. Rosenblatt, “The perceptron: A probabilistic model for information storage and organization in the brain,” Psychological Review, vol. 65, no. 6, pp. 386-408, 1958, doi: 10.1037/h0042519.
- A. Krizhevsky, I. Sutskever, and G. E. Hinton, “ImageNet classification with deep convolutional neural networks,” in Proc. Adv. Neural Inf. Process. Syst. (NeurIPS), Dec. 2012, pp. 1097-1105, doi: 10.1145/3065386.
- Badan Informasi Geospasial (BIG), “Peta pasang surut dan pola pasut perairan Indonesia,” [Online]. Available: https://tides.big.go.id/