 Kanada Kurniawan
Bab 5 - Overfitting, Regularisasi dan Evaluasi untuk Data Iklim
Prasyarat: Bab 2 (regresi, MAE/MSE), Bab 3 (klasifikasi, metrik), Bab 4 (pelatihan, learning curve, callback). Bab 5 adalah “jembatan” antara kemampuan membangun model dan evaluasi yang jujur untuk operasional.
Catatan: Materi bab ini adalah materi pengenalan, bukan hasil riset baru. Seluruh isi merupakan ringkasan ulang literatur machine learning, dengan contoh-contoh yang dekat dengan dunia meteorologi Indonesia.
Tujuan Pembelajaran
Setelah menyelesaikan bab ini, Anda diharapkan mampu:
- Mendiagnosa underfit/overfit melalui learning curve dan konsep bias-variance.
- Menerapkan regularisasi (L2, dropout, early stopping) untuk mencegah overfit.
- Memilih metrik operasional yang tepat (MAE/RMSE/R²/Willmott/KGE dan CSI/FAR/POD/TS) sesuai tujuan.
- Menerapkan cross-validation deret waktu yang benar (walk-forward/blocked) dan mencegah leakage.
5.1 Bias-Variance: Dua Sumber Kesalahan
Setiap model memiliki dua jenis kesalahan struktural. Kerangka ini juga yang dipakai literatur verifikasi operasional - misalnya bagaimana WMO meninjau keandalan metrik perkiraan [1]; rujukan standar verifikasi perkiraan adalah Jolliffe & Stephenson [2], dan untuk deep learning umum (termasuk aspek bias-variance) lihat Goodfellow et al. [3]:
- Bias tinggi - model terlalu sederhana, tidak menangkap pola data (underfit). Misal: memakai garis lurus untuk data yang jelas tidak linear.
- Varians tinggi - model terlalu sensitif pada data latih; sedikit perubahan data mengubah prediksi besar (overfit). Misal: jaringan sangat besar yang “menghafal” noise.
Ini bukan dua “tipe” yang terpisah, melainkan trade-off: saat kapasitas model naik, bias turun tetapi varian naik. Titik keseimbangan terbaik adalah di mana error total (bias + varian + noise) minimal - dicapai di “titik manis” antara underfit dan overfit.
Analoginya di meteorologi: peramal yang “selalu memprediksi rata-rata klimatologi” punya bias tinggi namun varian nol (tidak pernah meleset besar, tapi selalu kurang tajam). Peramal yang “selalu memprediksi kondisi tahun lalu persis” bisa sangat akurat untuk data yang dihafalnya, tetapi varian tinggi - memburuk drastis saat kondisi berubah. Kita ingin peramal yang berada di tengah: mengikuti pola nyata tetapi tidak menghafal kebetulan tahun lalu.
Tabel 5.1: Perbandingan pola underfit, fit baik, dan overfit.
| Aspek | Underfit | Fit baik | Overfit |
|---|---|---|---|
| Kapasitas model | Terlalu kecil | Cukup | Terlalu besar |
| Train error | Tinggi | Rendah | Sangat rendah (mendekati 0) |
| Val/Test error | Tinggi | Rendah | Naik kembali |
| Penyebab umum | Model/fitur/algoritma sederhana | Tuning tepat | Terlalu banyak parameter/epoch |
5.2 Mendiagnosa via Learning Curve
Cara paling langsung melihat underfit/overfit: plot train error vs validation error terhadap epoch (sudah dikenalkan Bab 4 §4.7):
- Underfit: kedua kurva tinggi & datar - model tidak mampu belajar. Solusi: kapasitas lebih besar, fitur lebih baik, LR lebih besar.
- Overfit: train terus turun, validation naik setelah titik tertentu. Solusi: regularisasi (§5.3), lebih banyak data, lebih sedikit parameter, early stopping.
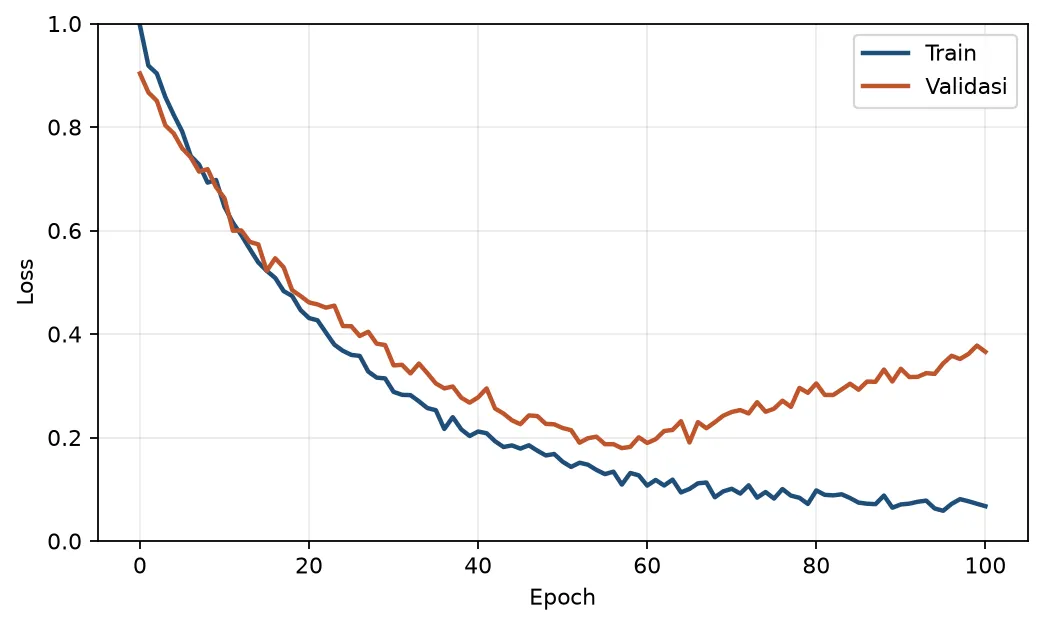
Gambar 5.1: Learning curve klasik: train terus turun, validation naik setelah titik tertentu (overfit).
Gambar 5.1 adalah pola overfit paling umum. Perhatikan titik di mana val mulai naik - itu sinyal bahwa model mulai menghafal.
Untuk klasifikasi, kurva yang sama bisa dipakai dengan loss (cross-entropy); untuk regresi, dengan MAE/MSE.
Berapa “jauh” overfit dikatakan buruk?
Tidak ada angka pasti, tetapi indikator umum:
- Jika val error naik secara konsisten (bukan fluktuasi kecil) setelah titik tertentu → sudah overfit.
- Jika train error mendekati nol sementara val error jauh lebih besar → overfit jelas.
- Bandingkan dengan baseline (Bab 2): jika model overfit masih kalah dari baseline sederhana di validasi, model itu tidak berguna - buang atau perbaiki.
Kunci: kita menilai pada validasi (dan akhirnya test), bukan train. Nilai train yang luar biasa rendah adalah jebakan umum.
5.3 Regularisasi: Mencegah Overfit
Regularisasi adalah teknik yang “menahan” model agar tidak terlalu bebas menghafal data. Empat teknik utama:
1. Early stopping (sudah dikenal)
Hentikan pelatihan saat validation mulai tidak membaik (Bab 4 §4.6). Paling mudah dan hampir selalu membantu.
Kode 5.1 - Early stopping dengan restore best weights.
import tensorflow as tf

callbacks = [
    tf.keras.callbacks.EarlyStopping(
        monitor="val_loss", patience=15, restore_best_weights=True
    )
]
Nilai patience=15 di Kode 5.1 hanyalah titik mulai. Nilai optimal bergantung pada
seberapa berisik (noisy) kurva validasi Anda: pada data cuaca/hujan yang fluktuasinya
kuat, patience yang terlalu kecil bisa menghentikan pelatihan karena fluktuasi, bukan
konvergensi sejati - sebaliknya, pada dataset besar dengan loss halus, patience besar
hanya membuang waktu. Mulai dengan 10-20, amati kurva, lalu sesuaikan.
2. Regularisasi L2 (weight decay)
Menambahkan penalti ke loss sebanding dengan kuadrat besarnya bobot:
Persamaan (5.1): λ (lambda) mengontrol kekuatan penalti. Model “didorong” memakai bobot
kecil, sehingga tidak terlalu bergantung pada satu fitur. Di Keras:
tf.keras.layers.Dense(8, activation="relu", kernel_regularizer=tf.keras.regularizers.l2(1e-4))Catatan untuk pelanjut: istilah “L2” dan “weight decay” baru menjadi benar-benar
identik pada SGD vanila. Pada optimizer adaptif seperti Adam, menambahkan penalti L2 ke
dalam loss tidak sama dengan decoupled weight decay (penalti terpisah pada parameter
weight_decay, dikenal sebagai AdamW) - versi terpisah ini sering lebih stabil [4].
Nuansa ini tidak diperlukan untuk latihan bab ini; cukup pakai kernel_regularizer.
3. Dropout
Selama pelatihan, dropout mematikan sebagian neuron secara acak (mis. 20-50%). Ini memaksa jaringan belajar dengan “banyak versi” model sehingga lebih robust. Saat evaluasi, neuron aktif semua.
tf.keras.layers.Dropout(0.3)Kode 5.2 - Contoh arsitektur dengan regularisasi (kernel regularizer L2 + dropout).
model = tf.keras.Sequential([
    tf.keras.layers.Dense(32, activation="relu",
                          kernel_regularizer=tf.keras.regularizers.l2(1e-4), input_shape=(n,)),
    tf.keras.layers.Dropout(0.3),
    tf.keras.layers.Dense(16, activation="relu",
                          kernel_regularizer=tf.keras.regularizers.l2(1e-4)),
    tf.keras.layers.Dropout(0.2),
    tf.keras.layers.Dense(1),
])
4. Batch Normalization (sekilas)
Menormalkan aktivasi di dalam jaringan agar pelatihan lebih stabil; sering dipakai bersamaan. Dibahas singkat; paling berguna di jaringan yang lebih dalam (Bab 7).
Kapan memakai yang mana?
- Data kecil + overfit ringan → early stopping + L2 ringan.
- Overfit menengah-berat → tambah dropout.
- Underfit → jangan tambah regularisasi; perbaiki kapasitas/fitur dulu.
Aturan penting: jangan menambah regularisasi hanya karena “model tidak jalan” tanpa melihat learning curve - bisa memperburuk underfit.
Bagaimana regularisasi bekerja secara intuitif?
- L2 “mengecilkan” bobot: model tidak boleh bertumpu besar pada satu fitur, sehingga lebih tahan terhadap noise pada fitur tertentu (Persamaan 5.1).
- Dropout membuat jaringan belajar dengan “ansambel efektif” dari banyak sub-jaringan (neuron acak dimatikan), sehingga tidak ada neuron yang menjadi titik tunggal kegagalan; konsep ini diperkenalkan oleh Srivastava et al. (2014) [5].
- Early stopping membatasi berapa lama model boleh belajar, mencegah model “menghafal” cukup dalam untuk menangkap noise.
Ketiganya menyerang arah berbeda dari masalah yang sama: terlalu bebasnya model menyesuaikan data latih.
Contoh sederhana efek L2
Bayangkan fitur kelembapan penting untuk hujan. Tanpa L2, model bisa memberi bobot besar pada kelembapan dan mengabaikan yang lain; dengan L2, bobot besar “dikenai biaya” (penalti kuadrat) sehingga model lebih menyebar bobotnya. Efeknya: prediksi lebih stabil saat ada sedikit noise pada pengukuran kelembapan - relevan karena data lapangan selalu ber-noise.
Memilih kekuatan regularisasi (lambda & dropout rate)
- L2 lambda: mulai dari
1e-4-1e-3. Terlalu kecil → tidak berefek; terlalu besar → model “terlalu tumpul” (underfit). Lihat kurva. - Dropout rate: mulai
0.2-0.5untuk lapisan tersembunyi. Terlalu tinggi → model sulit belajar di data kecil; pada data sangat kecil (di bawah ribuan sampel), mulai lebih rendah (mis.0.1-0.2). - Aturan: ubah satu demi satu, pantau val - seperti tuning hyperparameter di Bab 4.
Perbandingan kode lengkap (Kode 5.2 & 5.3 dipakai bersama)
Kode 5.1-5.2 menunjukkan pola; dalam notebook ch-05-04_metrik_walkforward.ipynb,
build_model(reg=True, drop=0.3) menggabungkan L2 + dropout dan dibandingkan dengan
versi tanpa regularisasi pada learning curve serta metrik test - latihan benarnya di
§5.8.
5.4 Memilih Metrik Operasional yang Tepat
Sekarang kita masuk bagian yang paling membedakan buku ini dengan buku ML umum: metrik yang benar untuk meteorologi bergantung pada fenomena dan tujuan.
Untuk regresi (besaran kontinu)
- MAE - galat rata-rata, mudah dipahami (satuan sama). Lebih tahan terhadap pencilan daripada RMSE (tidak mengkuadratkan galat) - tetapi bukan kebal: satu galat ekstrem 100 memberi kontribusi 100, sama seperti 100 galat yang bernilai 1.
- RMSE - akar MSE; menghukum galat besar lebih. Selalu ≥ MAE; selisihnya menunjukkan bobot galat ekstrem.
- R² - proporsi varians yang dijelaskan (
1 − SSE/SST); bisa negatif jika model lebih buruk daripada sekadar memprediksi rata-rata target. R² negatif pada data uji adalah tanda bahaya (model gagal total), bukan hanya “kurang informatif”; di luar range training R² umumnya turun tajam karena model belum pernah lihat skala tersebut. - Willmott index (d) - antara 0-1; lebih “ramah” pada data berskala (sering dipakai hidrologi/meteo). Versi original merujuk Willmott (1981) [6]; ada versi modifikasi (Willmott et al., 2012) [7] yang rumusnya sedikit berbeda - catat versi mana yang dipakai saat mengimplementasikan.
- KGE (Kling-Gupta efficiency) - menggabungkan korelasi, bias, dan variabilitas; populer di hidrologi; dirinci oleh Gupta et al. (2009) [8].
Sebagai referensi dasar evaluasi & praktik model pada umumnya, lihat pula [3]; untuk verifikasi perkiraan yang lebih mendalam, lihat Jolliffe & Stephenson [2].
Tabel 5.2: Panduan memilih metrik regresi.
| Situasi | Metrik yang disarankan |
|---|---|
| Melaporkan galat khas ke pengguna umum | MAE |
| Memberi bobot pada galat besar (ekstrem) | RMSE |
| Menilai kesesuaian pola secara luas | R² / KGE |
| Data dengan skala & bias sering dibahas (hidrologi) | KGE / Willmott |
| Standar laporan operasional meteo | MAE + RMSE (keduanya) |
Bahasa setiap metrik dalam satu kalimat
- MAE: “rata-rata, sejauh apa prediksi meleset?” (dalam satuan asli).
- RMSE: “seberapa besar galat ekstrem ikut berbobot?” (akar kuadrat rata-rata).
- R²: “berapa persen variasi data bisa dijelaskan model?” (0-1; bisa negatif).
- Willmott d: “seberapa dekat prediksi ke aktual dalam skala 0-1 yang ‘ramah’ terhadap pencilan” - sering digunakan pada laporan hidrologi Indonesia.
- KGE: “seberapa baik model menangkap korelasi, tanpa bias, dan variabilitas sekaligus?” (terurai oleh Gupta et al., 2009 [8]).
KGE dirumuskan lewat tiga komponen: korelasi (r), bias rasio, dan rasio variabilitas;
nilai 1 = sempurna. Untuk model yang selalu memprediksi rata-rata klimatologi,
korelasi = 0 dan rasio variabilitas = 0, sehingga KGE = 1 − √2 ≈ −0.41 - bukan 0 seperti
yang kadang keliru disebut. Nilai di bawah baseline itu berarti lebih buruk daripada
memakai rata-rata. Konteks ini membuat rekomendasi pemilihan di Tabel 5.2 menjadi masuk
akal.
Contoh ukuran cepat untuk memahami skala metrik
Untuk data uji dengan y = [10, 20, 30] dan prediksi ŷ = [12, 19, 29]:
- MAE =
(2+1+1)/3 = 1.33 - RMSE ≈
√((4+1+1)/3) ≈ 1.41 - R² =
1 − (6/200) ≈ 0.97(contoh ini hanya untuk memahami skala; dengan 3 data saja, angka R² sangat tidak stabil dan tidak mencerminkan performa nyata - selalu uji pada data yang cukup banyak, §5.7) - Willmott d ≈
0.99 - (KGE perlu varian pred/obs; dihitung di notebook)
Bandingkan cerita: MAE/RMSE memberi ukuran fisik, R²/d memberi kualitas pola - keduanya dilaporkan bergantian sesuai tujuan.
Untuk klasifikasi / kejadian langka
Bab 3 sudah mengenalkan precision/recall/F1. Di operasional, kuartet klasik peramal:
- POD (probability of detection) = recall =
TP/(TP+FN)- “berapa kejadian yang tertangkap?”. - FAR (false alarm ratio) =
FP/(TP+FP)- “dari yang diumumkan, berapa yang meleset?”. - CSI (critical success index) =
TP/(TP+FP+FN)- “skor sukses”, menghukum baik miss maupun false alarm. - TS mengacu pada threat score - sama dengan CSI.
Tabel 5.3: Kuartet verifikasi klasik WMO.
| Metrik | Formula | Pertanyaan | Target |
|---|---|---|---|
| POD | TP/(TP+FN) | Kejadian tertangkap? | tinggi |
| FAR | FP/(TP+FP) | Banyak false alarm? | rendah |
| CSI/TS | TP/(TP+FP+FN) | Skor sukses keseluruhan | tinggi |
| (Bias score) | (TP+FP)/(TP+FN) | Model terlalu sering/malas prediksi? | ~1 |
Pedoman resmi: WMO Guidelines on the Verification of Operational Forecasts [1].
Bias score (terlalu sering atau terlalu jarang memprediksi?): Bias score =
(TP+FP)/(TP+FN) menjawab: “berapa jumlah kejadian yang diumumkan dibandingkan yang benar
terjadi?” Nilai > 1 berarti model over-forecast - terlalu sering mengumumkan kejadian,
kemungkinan banyak peringatan kosong; nilai < 1 berarti under-forecast - terlalu jarang,
kemungkinan banyak kejadian terlewat. Perlu diingat: bias score hanya menghitung
kecenderungan jumlah, bukan ketepatan posisi kejadian (waktu/wilayah) - dua model
dengan bias score sama bisa jauh berbeda kualitasnya. Karena itu ia selalu dibaca
bersama POD/FAR/CSI, bukan berdiri sendiri.
Mengapa ini penting? Data kejadian langka (hujan deras, gelombang tinggi, badai) membuat akurasi menyesatkan (Bab 3). CSI/POD/FAR memberi gambaran yang jujur tentang nilai operasional model, bukan sekadar “benar berapa persen”.
Numerik singkat: beda cerita antar metrik
Ambil kasus: dari 100 hari, 10 hari benar-benar hujan deras. Model A dan B:
| TP | FP | FN | Akurasi | POD | FAR | CSI | |
|---|---|---|---|---|---|---|---|
| Model A | 8 | 2 | 2 | 96% | 0.80 | 0.20 | 0.67 |
| Model B | 3 | 0 | 7 | 93% | 0.30 | 0.00 | 0.30 |
Tabel 5.4: Dua model, cerita yang sangat berbeda.
Model A berakurasi 96% dan POD 0.80 - tangkapannya bagus, tapi 20% peringatan salah (FAR). Model B tidak pernah salah beri peringatan (FAR 0) - tapi melewatkan 7 dari 10 kejadian (POD 0.30). CSI mengungkap yang sebenarnya: keduanya tidak hebat, dan tujuan operasional yang menentukan mana yang lebih diterima (peringatan dini → Model A; biaya evakuasi mahal → Model B). Ini persis alasan kita tidak bisa berhenti di akurasi.
5.5 Cross-Validation untuk Deret Waktu: Walk-Forward
Cross-validation (bagi-train-val-test berulang) untuk data independen identik memakai k-fold acak. Data deret waktu tidak independen: nilai berdekatan berkorelasi, dan penggunaan masa depan saat latih = leakage (Bab 2 §2.7).
Solusinya: walk-forward validation (juga disebut forward chaining atau expanding window), yang mensimulasikan penggunaan operasional:
- Mulai dengan windows latih di awal deret.
- Prediksi window berikutnya (untuk validasi).
- Geser batas latih maju; ulangi.
Tabel 5.5: Skema walk-forward (ilustrasi 5 fold; horizon = 20 langkah).
| Fold | Train | Validate |
|---|---|---|
| 1 | t1-t100 | t101-t120 |
| 2 | t1-t120 | t121-t140 |
| 3 | t1-t140 | t141-t160 |
| 4 | t1-t160 | t161-t180 |
| 5 | t1-t180 | t181-t200 |
Pada Tabel 5.5, latih selalu hanya masa lalu; validasi selalu di depan batas latih. Ini mereplikasi kondisi nyata: saat model dipakai, ia hanya tahu data hingga hari ini.
Tabel 5.5 memakai expanding window: latih selalu dimulai dari awal deret (t1), hanya batas akhirnya yang bergeser. Alternatifnya: sliding window, di mana latih juga bergeser (mis. t1-t100, t21-t120, dst). Expanding window memakai semua data sejarah - cocok untuk deret dengan tren jangka panjang, tetapi mulai berat saat deret sangat panjang; sliding window lebih cocok ketika perilaku lama tidak lagi relevan karena distribusi berubah seiring waktu. Pilih sesuai karakter data Anda, dan sebutkan pilihan itu saat melaporkan hasil.
Kode 5.3 - Contoh walk-forward sederhana (pseudo; lengkap di notebook).
horizon = 20
results = []
for start in range(0, len(X) - horizon, 20):
    i_end = start + 100          # contoh: latih 100 langkah dari posisi awal
    Xtr_fold, ytr_fold = X[start:i_end], y[start:i_end]
    Xva_fold, yva_fold = X[i_end:i_end+horizon], y[i_end:i_end+horizon]
    model = build_model()        # model baru tiap fold (jujur)
    model.fit(Xtr_fold, ytr_fold, epochs=60, batch_size=32, verbose=0)
    results.append(mae(yva_fold, model.predict(Xva_fold, verbose=0)))
print("Rata-rata MAE walk-forward:", round(sum(results)/len(results), 4))
Penting: latih model baru di tiap fold - jika Anda melatih sekali & memprediksi semua fold, informasi masa depan bocor.
Catatan: Kode 5.3 (dan contoh di notebook) menggambarkan variant sliding window — batas
kiri latih (start) juga bergeser tiap fold. Variant ini valid untuk data tanpa tren
jangka panjang; untuk deret dengan tren kuat, versi expanding window (latih selalu
mulai dari awal deret, hanya batas kanan bergeser, seperti Tabel 5.5) lebih cocok. Kode
hampir sama — cukup mantenir start = 0 dan hanya berubah i_end, misalnya:
for i_end in range(100, len(X) - horizon, 20): Xtr_fold, ytr_fold = X[:i_end], y[:i_end].
Kenapa bukan “k-fold acak” untuk data iklim?
Data cuaca menunjukkan autokorelasi (nilai hari ini mirip hari kemarin). K-fold acak menempatkan sampel berdekatan di train dan test, sehingga evaluasi “menyontek” dari ketetanggaan. Studi kasus Bab 8-9 akan memperlihatkan betapa besar perbedaannya: model yang tampak hebat pada k-fold acak bisa gagal total pada walk-forward - persis perilaku yang akan dialami di produksi.
k-fold (blocked) sebagai alternatif
Jika dataset panjang dan Anda butuh lebih banyak fold, pakai blocked/rolling k-fold: potong deret menjadi blok berurutan, lalu untuk tiap fold latih blok-blok sebelum fold validasi tersebut (tanpa melihat masa depan). Ini “saudara” walk-forward dengan jumlah fold tetap. Intinya tetap sama: validasi selalu mengikuti waktu, bukan kebalikannya.
Kapan memakai k-fold acak masih ok?
Hanya jika data Anda benar-benar i.i.d. (misal koleksi gambar cuaca independen). Untuk deret waktu stasiun, pasang surut, atau hujan - selalu walk-forward/blocked. Ini aturan yang akan dipakai keras di Bab 8-9.
Kesalahan umum saat walk-forward
- Berbagi preprocessing statistik antar fold - jika Anda menghitung normalisasi (min/max/z-score) dari seluruh data sebelum membagi fold, masa depan “bocor” ke latih. Solusi: hitung statistik hanya dari fold latih, lalu terapkan ke validasi-fold (Bab 6 memperdalam).
- Memakai model yang di-fit sekali untuk semua fold - setiap fold harus punya model sendiri yang dilatih hanya dengan data sebelum fold tersebut (Kode 5.3).
- Menghitung metrik pada campuran semua fold - laporkan per-fold atau rata-rata; jangan mengumpulkan prediksi semua fold menjadi satu set (karena fold awal dan akhir tidak sebanding).
5.6 Menerapkan Evaluasi: Alur Lengkap
Untuk menutup Bab 5, rangkum evaluasi yang jujur dalam urutan:
- Split (bab 2): train / val / test berbasis waktu; test hanya dipakai sekali.
- Baseline (bab 1-2): ukur model sederhana (persistence, klimatologi, linear) dulu.
- Latih & pantau (bab 4): learning curve; early stopping saat val berhenti membaik.
- Diagnosa (bab 5): overfit? → regularisasi; underfit? → kapasitas/fitur.
- Evaluasi (bab 5): regresi → MAE/RMSE/R²/KGE (dan Willmott); kejadian → CSI/POD/FAR + threshold.
- Validasi temporal (bab 5): walk-forward untuk mengukur generalisasi seiring waktu.
- Lapor (bab 10): angka + satuan + threshold + keterbatasan, banding dengan baseline.
Langkah 5-6 adalah “izin keluar” sebelum klaim apa pun: jangan pernah melaporkan “prediksi akurat 97%” tanpa metrik yang sesuai konteks (KGE/CSI, bukan akurasi dangkal).
Analisis residu: melihat di mana model gagal
Metrik memberi satu angka; residu (selisih aktual-prediksi) menunjukkan di mana. Cara diagnostik sederhana yang sering mengungkap masalah:
- Plot residu terhadap waktu - apakah ada musim atau bulan yang selalu meleset? (mis. model buruk di puncak hujan karena data tidak seimbang.)
- Plot residu terhadap fitur penting - misal, apakah error membesar ketika kelembapan sangat tinggi?
- Distribusi residu - residu yang condong kuat (skew) menandakan model bias sistematis (misal selalu memprediksi terlalu rendah pada hujan besar).
Cara membacanya: residu yang berayun mengikuti musim (mis. selalu positif di musim hujan, selalu negatif di musim kemarau) mengisyaratkan model gagal menangkap pola musiman - tambahkan fitur musiman (bulan, hari dalam tahun) atau interaksi. Residu yang membesar saat kelembapan sangat tinggi mengisyaratkan hubungan non-linear - coba transformasi target atau fitur interaksi. Pola sistematis yang masih terlihat di residu = sinyal bahwa ada struktur yang belum dipelajari model.
Analisis residu hampir selalu menghasilkan ide perbaikan: fitur baru, transformasi target
(mis. log(y+1) untuk hujan), atau threshold yang lebih sesuai. Inilah “analisis
kesalahan” yang disebut di Bab 4 - dan merupakan keterampilan paling berharga seorang
praktisi model cuaca.
Kapan sebuah model “lulus”?
Tidak ada formulasi tunggal; kerangka penilaian:
- Lulus teknis - metrik sesuai target & mengalahkan baseline di walk-forward.
- Lulus operasional - metrik memenuhi tolok ukur layanan (mis. toleransi pasang ±0.10 m, CSI ≥ 0.4 untuk peringatan dini).
- Lulus praktis - model dapat dipelihara (data tersedia, retraining terjadwal, interpretasi cukup bagi pengguna, Bab 10).
Hanya ketika ketiganya terpenuhi model layak diusulkan untuk produksi. Bab 8-9 mempraktikkan ketiga mata uji ini pada kasus nyata.
Memilih rangkaian eksperimen yang efisien
Ketika mencari perbaikan (regularisasi, kapasitas, fitur), rancang eksperimen agar jawabannya jelas:
- Satu perubahan per eksperimen - ubah dropout saja, bandingkan; lalu L2, dst. Mengubah banyak variabel sekaligus membuat Anda tak tahu penyebab perbedaan.
- Tetapkan metrik keputusan tunggal - misal: “val MAE” untuk regresi, “CSI pada periode validasi” untuk kejadian - dipakai konsisten di semua eksperimen.
- Catat hasil di tabel - kolom: konfigurasi, train/val metrik, parameter. Ini menjadi dokumen jejak keputusan (berguna saat laporan operasional, Bab 10).
- Gunakan seed tetap (Bab 1) agar perbedaan antar eksperimen bukan karena acak.
Tabel eksperimen bisa dimulai sesederhana menyalin output notebook ke satu lembar catatan; disiplin ini menghemat banyak waktu di Bab 8-9 ketika studi kasus menuntut banyak percobaan.
5.7 Membaca Metrik Secara Kritis
Angka metrik tidak berdiri sendiri. Sebelum melaporkan, tanyakan:
- Satuan & konteks - MAE 0.05 m untuk pasang surut baik atau buruk? Bandingkan dengan toleransi operasional (mis. ±0.10 m).
- Dibanding baseline? - metrik hanya bermakna relatif terhadap persistence/klimatologi.
- Metrik apa yang diukur? - akurasi untuk fenomena langka menyesatkan; gunakan CSI/POD/FAR (regresi: KGE/MAE/RMSE sesuai tujuan).
- Apakah angka stabil? - satu run bisa beruntung; gunakan beberapa seed atau walk-forward untuk melihat varians.
- Threshold mana? - POD/FAR bergantung threshold; selalu laporkan threshold yang dipakai.
Disiplin ini - bukan sekadar “akurasi tinggi” - yang membedakan laporan yang bisa dipercaya di dunia operasional meteorologi.
FAQ singkat
Kapan KGE lebih baik daripada R²? Jika Anda peduli pada bias/skala (khas hidrologi & peramalan), KGE memisah korelasi, bias, dan variabilitas. R² hanya korelasi-pola; model dengan bias besar tapi pola bagus bisa R² tinggi padahal tidak akurat.
Apakah dropout membuat model selalu lebih baik? Tidak. Dropout menambah regularisasi - bagus untuk overfit, tetapi bisa memperburuk underfit. Terapkan sesuai diagnosis.
Walk-forward lebih lambat - apakah wajib? Untuk klaim evaluasi pada data iklim, ya. Kecepatan bisa ditingkatkan dengan model kecil / subset; kejujuran tidak bisa dikompromi.
Apa beda CSI dan TS? Dalam praktik peramalan, keduanya merujuk rumus yang sama; TS (threat score) adalah nama lama untuk CSI.
Mengapa metrik “nilai rata-rata” tidak cukup? Rata-rata menyembunyikan distribusi: MAE 2 mm bisa berarti “selalu meleset 2 mm” atau “sempurna kecuali beberapa hari ekstrem”. Laporkan distribusi error (kuantil, plot) bila penting.
Apakah saya perlu melaporkan semua metrik? Tidak - pilih yang informatif untuk tujuan Anda (Tabel 5.2) dan sertakan baseline + threshold. Lebih baik sedikit angka yang bermakna daripada banyak angka yang membingungkan.
5.8 Latihan
Soal konsep
- Jelaskan bias-variance trade-off dengan analogi meteorologi.
- Bagaimana learning curve membantu memutuskan apakah menambah dropout atau mengurangi kapasitas?
- Mengapa RMSE ≥ MAE selalu? Apa implikasi untuk data hujan ekstrem?
- Kapan memakai R² vs KGE? Jelaskan kelemahan R² pada data di luar range training.
Latihan praktik (notebook ch-05-04_metrik_walkforward.ipynb)
- Ambil model klasifikasi Bab 3; evaluasi dengan POD/FAR/CSI di beberapa threshold. Buat tabel ringkasnya.
- Bangun model regresi Bab 2; hitung MAE, RMSE, R², Willmott d, dan KGE (gunakan fungsi sederhana). Diskusikan perbedaan cerita tiap metrik.
- Terapkan regularisasi (L2 + dropout) pada model yang overfit; bandingkan learning curve sebelum/sesudah.
- Terapkan walk-forward (fold) pada data pasang surut Bab 2 dan bandingkan MAE rata-rata dengan split tunggal.
- (Proyek mini) Tulis fungsi evaluasi reusable: input (y_true, y_pred) → output MAE/RMSE/R²/KGE atau POD/FAR/CSI. Simpan untuk Bab 8-9.
Ringkasan
- Overfit = varian tinggi (menghafal data latih); underfit = bias tinggi (terlalu sederhana); keduanya saling trade-off (bias-variance).
- Learning curve adalah alat diagnosis utama: train terus turun + val naik → overfit; keduanya tinggi & datar → underfit.
- Regularisasi: early stopping (kapan berhenti), L2 (kecilkan bobot, Persamaan 5.1), dropout (latih “ansambel” neuron acak) - terapkan berdasarkan diagnosis, bukan asal.
- Metrik regresi: MAE (galat khas), RMSE (bobot galat ekstrem), R² (pola), Willmott (skala ramah), KGE (korelasi+bias+variabilitas).
- Metrik kejadian langka: POD (kejadian tertangkap), FAR (alarm palsu), CSI/TS (skor sukses); akurasi menyesatkan.
- Cross-validation deret waktu: walk-forward/blocked (validasi selalu setelah latih) - bukan k-fold acak; jaga preprocessing per-fold agar tidak bocor.
- Evaluasi jujur = metrik + satuan + threshold + baseline + walk-forward + analisis residu.
References
- World Meteorological Organization, “WMO guidelines on the verification of operational forecasts,” WMO, Geneva, Switzerland, 2018.
- I. T. Jolliffe and D. B. Stephenson, Forecast Verification: A Practitioner’s Guide in Atmospheric Science, 2nd ed. Chichester, UK: Wiley, 2011, doi: 10.1002/9781119960003.
- I. Goodfellow, Y. Bengio, and A. Courville, Deep Learning. Cambridge, MA, USA: MIT Press, 2016.
- I. Loshchilov and F. Hutter, “Decoupled weight decay regularization,” in Proc. Int. Conf. on Learning Representations (ICLR), 2019. arXiv:1711.05101.
- N. Srivastava, G. Hinton, A. Krizhevsky, I. Sutskever, and R. Salakhutdinov, “Dropout: A simple way to prevent neural networks from overfitting,” J. Mach. Learn. Res., vol. 15, no. 1, pp. 1929-1958, 2014.
- C. J. Willmott, “On the validation of models,” Phys. Geogr., vol. 2, no. 2, pp. 184-194, 1981.
- C. J. Willmott, S. M. Robeson, and K. Matsuura, “A refined index of model performance,” Int. J. Climatol., vol. 32, no. 6, pp. 573-580, 2012.
- H. V. Gupta, H. Kling, K. K. Yilmaz, and G. F. Martinez, “Decomposition of the mean squared error and NSE performance criteria: Implications for improving hydrological modelling,” J. Hydrol., vol. 377, no. 1-2, pp. 80-91, 2009, doi: 10.1016/j.jhydrol.2009.08.003.