 Kanada Kurniawan
Bab 8 - Studi Kasus: Prediksi Pasang Surut di Perairan Indonesia (Contoh Cilacap)
Prasyarat: Bab 2 (regresi, baseline), Bab 5 (metrik, walk-forward), Bab 6 (data, normalisasi, split), Bab 7 (LSTM/GRU, windowing, multi-horizon). Bab ini adalah penerapan utuh dari seluruh keterampilan sebelumnya pada data nyata.
Catatan: Materi bab ini adalah materi pengenalan, bukan hasil riset baru. Seluruh isi merupakan ringkasan ulang literatur machine learning, dengan contoh-contoh yang dekat dengan dunia meteorologi Indonesia.
Tujuan Pembelajaran
Setelah menyelesaikan bab ini, Anda diharapkan mampu:
- Menjalankan proyek end-to-end prediksi pasang surut dari data terbuka (IOC/UHSLC/PSMSL), dengan Cilacap sebagai contoh reproducible.
- Menerapkan pipeline Bab 7 (baseline persistence vs MLP vs LSTM/GRU) dengan walk-forward.
- Mengevaluasi MAE/RMSE terhadap toleransi tinggi pasang dan memplot prediksi 1-7 hari.
- Menjelaskan framing jujur: machine learning untuk prakiraan cepat dan pengisian gap data, bukan klaim riset baru.
- Mengenali keterbukaan data pasang surut per lokasi: memilih station dengan data terbuka yang paling representatif, atau memetakan strategi fallback ketika lokasi studi tidak punya tide gauge terbuka.
8.1 Konteks Lokal: Perairan Indonesia dan Mengapa Cilacap
Banjir rob - naiknya muka laut yang menggenangi daratan pesisir - adalah masalah nyata di banyak kota pantai Indonesia: Jakarta, Semarang, Cilacap, dan pesisir utara Jawa [1]. Di kota-kota yang rendah dan padat, satu pasang tinggi yang bertepatan dengan debit sungai besar atau storm surge dapat menggenangi permukiman, mengganggu pelabuhan, dan memutuskan aktivitas ekonomi. Prakiraan tinggi air yang andal membantu peringatan dini dan keputusan operasional.
Mengapa Cilacap sebagai contoh studi kasus
Buku ini memilih Cilacap (pantai selatan Jawa Tengah, -7,75° LS, 109,02° BT) sebagai stasiun demonstrasi karena tiga alasan praktis:
- Station aktif & terbuka: Cilacap adalah salah satu tide gauge Indonesia yang tercatat resmi di GLOSS (Global Sea Level Observing System) dengan ID 291, dan dilaporkan real-time oleh UNESCO/IOC Sea Level Station Monitoring Facility [2]. Data historis jangka panjangnya juga tersedia di PSMSL [3] dan UHSLC [4].
- Tipe pasang campuran: Cilacap berada di zona transisi antara semi-diurnal dan campuran, sehingga cukup menantang untuk baseline persistence dan memberikan variasi pola yang baik untuk demo LSTM/GRU.
- Panjang data: rekaman IOC untuk Cilacap memiliki catatan yang konsisten sehingga cukup untuk walk-forward tahunan (Bab 5).
Pembaca yang bekerja di stasiun lain (mis. Ambon GLOSS #68, Bitung GLOSS #69, Sibolga, Benoa GLOSS #49) dapat mengikuti pipeline identik dengan mengganti kode stasiun pada skrip unduh (§8.3). Tabel 8.3 merangkum station Indonesia yang datanya tersedia di sumber terbuka; untuk lokasi tanpa station terbuka, pilih station proksi dengan karakter oceanografi mirip atau gunakan model laut global (FES2014, GOT4.10) pada koordinat tersebut.
Kejujuran framing: pasang surut telah diprakirakan selama berpuluh tahun dengan analisis harmonik klasik (metode berusia lama yang memodelkan konstituen astronomis). Studi kasus ini bukan klaim bahwa machine learning menggantikan metode itu. Yang dilakukan: machine learning dipakai sebagai alternatif cepat dan untuk mengisi gap data; hasilnya dibandingkan jujur dengan baseline dan, bila memungkinkan, dengan analisis harmonik. Ini sejalan dengan prinsip buku (Bab 1 §1.10).
Mengapa studi kasus penting bagi pembaca
Studi kasus adalah kesempatan mempraktikkan seluruh rantai yang sudah dipelajari - bukan sekadar “model lagi”. Di sini pembaca akan mengalami:
- Konteks sebelum angka: memahami masalah (banjir rob) menentukan metrik dan tolok ukur yang dipakai.
- Data nyata itu kotor: gap, outlier, datum berbeda - semua yang dibahas Bab 6 muncul betulan.
- Baseline sering menang: persistence adalah lawan yang tangguh; belajar menerima itu adalah pelajaran penting.
- Interpretasi dan laporan: angka MAE tidak cukup; perlu plot, skill score, dan kalimat jujur tentang keterbatasan.
- Pemilihan station: ketika lokasi Anda tidak punya station terbuka, Anda belajar memilih proksi dan menjelaskan keterbatasannya - keterampilan yang sama pentingnya dengan membangun model.
Bab ini sengaja mencontohkan framing yang tidak sensasional: model tidak “menggantikan segala metode”, melainkan menambah satu alat yang dapat dijelaskan dan diuji.
8.2 Karakter Pasang Surut di Perairan Indonesia
Pasang surut di perairan Indonesia dikelompokkan menjadi tiga tipe utama [5]:
- Semi-diurnal: dua kali pasang dan dua kali surut per hari (mis. sebagian Selat Malaka, Laut Cina Selatan).
- Diurnal: satu kali pasang dan satu kali surut per hari (mis. sebagian pesisir Indonesia timur, Papua).
- Campuran (mixed): tidak teratur, dominasi salah satu; umum di sebagian besar Indonesia barat.
Tabel 8.1: Tipe pasang surut dan karakteristik dasarnya.
| Tipe | Siklus per hari | Daerah contoh | Konsekuensi prediksi |
|---|---|---|---|
| Semi-diurnal | 2 pasang + 2 surut | Selat Malaka, Natuna | Siklus ~12,42 jam |
| Diurnal | 1 pasang + 1 surut | Pesisir Indonesia timur | Siklus ~24,84 jam |
| Campuran | tidak teratur | Sebagian besar Indonesia barat | Kombinasi komponen |
Indonesia memiliki variasi tipe pasang surut yang kaya karena bentangan garis
pantainya yang luas dan dipengaruhi oleh karakteristik basin Pasifik dan Hindia [5].
Untuk station demo Cilacap, pola yang akan pembaca temui adalah campuran
condong semi-diurnal dengan komponen diurnal cukup kuat (terutama saat musim
tertentu) - khas pesisir selatan Jawa. Jika ingin tahu tipe station Anda, cara
cepat: hitung Formzahl F = (K1 + O1)/(M2 + S2) dari komponen harmonik [5] -
F < 0,25 semi-diurnal, 0,25-1,5 campuran condong semi-diurnal,
1,5-3,0 campuran condong diurnal, > 3 diurnal. Untuk pengguna machine
learning, pembacaan spektrum deret (FFT)
cukup untuk melihat periode dominan (Gambar 8.1).
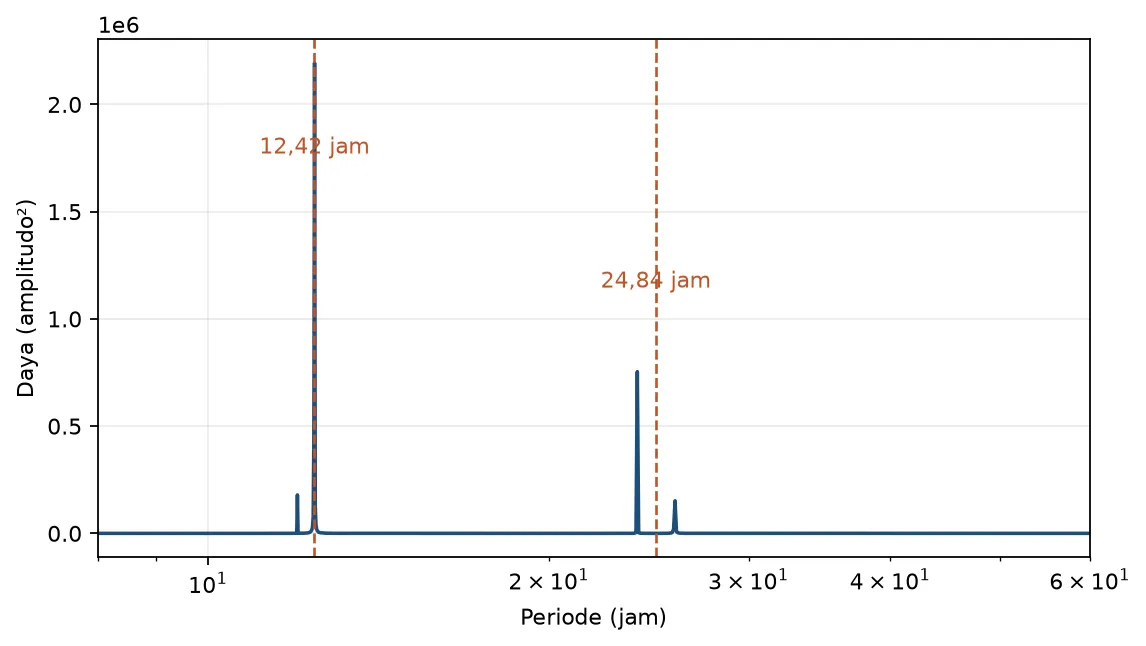
Gambar 8.1: Spektrum frekuensi muka air: puncak pada periode pasang surut semi-diurnal (~12,42 jam) dan diurnal (~24 jam).
Pola ini cocok dengan tipe campuran condong semi-diurnal di pesisir selatan Jawa.
Metode harmonik (tradisional) memodelkan y(t) sebagai jumlahan sinusoid dengan
frekuensi tetap dari konstituen astronomis (M2, S2, K1, O1, …) [5]. Machine learning
tidak “tahu” konstituen ini - ia belajar periodisitas dari data. Inilah beda yang perlu
dipahami pembaca: harmonik memakai teori fisis; deep learning memakai data. Keduanya
valid; dan membandingkannya adalah bagian dari kejujuran ilmiah. Kerangka teori model
deep learning secara umum dapat dirujuk pada [6]; kerangka forecasting praktis pada [7].
Model harmonik: mengapa masih relevan
Analisis harmonik bekerja karena pasang surut didorong oleh gaya gravitasi benda langit yang periodik dan dapat diprediksi jauh ke depan. Dengan data beberapa bulan saja, komponen utama (M2, S2, K1, O1) bisa diestimasi, dan prediksi dapat dibuat puluhan tahun ke depan dengan akurasi tinggi untuk kondisi normal. Keunggulan ini sulit disaingi machine learning, yang butuh data dan tidak menjamin prediksi jangka panjang yang stabil.
Namun harmonik juga punya kelemahan: ia mengasumsikan stasioneritas amplitudo/fase dalam jendela estimasi, dan gagal menangkap variabilitas non-periodik - misalnya kenaikan muka air saat badai, efek debit sungai Kapuas, atau perubahan lokal ([5] untuk catatan umum pengembangan). Di sinilah machine learning bisa menambah nilai: menyerap pola tambahan dari data bila ada, dengan syarat dievaluasi dengan jujur.
Perbandingan ringkas harmonik vs deep learning
Tabel 8.2: Perbandingan analisis harmonik dan pendekatan machine learning.
| Aspek | Analisis harmonik | Machine learning (LSTM/GRU) |
|---|---|---|
| Dasar | Teori fisis konstituen astronomis | Pola dari data |
| Data untuk bekerja | Beberapa bulan cukup | Butuh lebih banyak + beragam kondisi |
| Prediksi jangka panjang | Stabil (komponen tetap) | Mungkin menyimpang |
| Variabilitas non-periodik | Sulit | Bisa (jika ada di data) |
| Interpretasi | Komponen jelas (M2, S2…) | Kurang transparan |
| Biaya komputasi | Kecil | Sedang-besar |
Membaca Tabel 8.2 membantu memilih: untuk prakiraan rutin jangka panjang, harmonik tetap andal; untuk pemodelan cepat dan pengisian gap pada data yang “tidak murni astronomis”, machine learning praktis.
8.3 Dataset Pasang Surut: Sumber Terbuka dan Kualitas
Untuk pembaca yang ingin mereproduksi studi kasus ini dengan data nyata, tiga sumber utama dipakai buku ini. Semuanya terbuka dan gratis untuk riset/pendidikan dengan atribusi (rincian lisensi dan batasannya ada pada “Catatan lisensi dan penggunaan” di bawah).
Sumber data
- UNESCO/IOC Sea Level Station Monitoring Facility [2] - data real-time
dan near real-time untuk ratusan station global, termasuk 24 station di
Indonesia. Akses via endpoint publik:
Format: tab-separated, sampling 1-3 menit atau hourly. Periode maksimum per request ~30 hari; untuk arsip panjang, gunakan skrip pengulangan (https://www.ioc-sealevelmonitoring.org/bgraph.php?code=<KODE>&output=tab&period=<HARI>scripts/ download_ioc.py). - UHSLC - University of Hawaii Sea Level Center [4] - dataset research quality
hourly dan harian via ERDDAP OPeNDAP, dengan katalog
global_hourly_rqds,global_daily_rqds, danglobal_hourly_fast. Mendukung query REST (mis.global_hourly_rqds.csv?station_id=...&time>=...) yang ramah untuk pipeline Python. - PSMSL - Permanent Service for Mean Sea Level [3] - data rata-rata MSL bulanan jangka panjang (puluhan tahun) untuk 8 station Indonesia, dengan format RLR (Revised Local Reference) [9] yang sudah disesuaikan untuk konsistensi antar-stasiun. Cocok untuk analisis tren jangka panjang; kurang cocok untuk prakiraan jangka pendek karena resolusi bulanan.
Selain itu:
- BIG (tides.big.go.id) [1] - tabel pasut harmonik per lokasi (komponen konstituen, amplitudo, fase) yang dipakai BIG untuk prakiraan operasional; tidak menyediakan time-series tinggi air mentah yang mudah di-curl otomatis.
Catatan lisensi dan penggunaan
Lisensi tiap sumber berbeda dengan lisensi buku (CC BY-SA 4.0 yang mengizinkan penggunaan komersial):
- UNESCO/IOC Sea Level Station Monitoring Facility [2] - CC BY-NC 4.0 (non-komersial) per catatan resmi dataset (DOI 10.14284/482). Gratis untuk riset/pendidikan dan prakiraan operasional, tetapi tidak boleh dipakai untuk produk/jasa komersial; turunan dari data ini tetap non-komersial. Penggunaan di luar ketentuan tersebut memerlukan izin dari penyedia data (data originator) yang bersangkutan.
- UHSLC [4] - gratis untuk riset/pendidikan; sertakan atribusi “University of Hawaii Sea Level Center”; untuk penggunaan di luar itu, periksa kebijakan UHSLC saat mengunduh.
- PSMSL [3] - gratis; wajib menyertakan sitasi dataset (Holgate et al. 2013) dan referensi data/stasiun.
- BIG (tides.big.go.id) [1] - publik untuk keperluan informasi pasut; atribusi BIG dianjurkan.
Karena buku ini berlisensi CC BY-SA 4.0 (penggunaan komersial diperbolehkan), jika Anda menggabungkan data non-komersial (IOC) ke dalam produk turunan, kewajiban non-komersial dari data tersebut tetap berlaku - cantumkan peringatan eksplisit di produk Anda.
Station Indonesia yang datanya tersedia di sumber terbuka
Tabel di bawah merangkum station Indonesia yang datanya dapat diunduh dari IOC, UHSLC, atau PSMSL. Daftar ini bukan inventaris lengkap; verifikasi terkini sebelum eksperimen karena status station (aktif/non-aktif) berubah.
Tabel 8.3: Station pasang surut Indonesia di sumber terbuka (Sept 2026).
| Kode IOC | Nama | Lat | Lon | GLOSS | Sumber | Catatan |
|---|---|---|---|---|---|---|
cili | Cilacap | -7,75 | 109,02 | 291 | IOC + PSMSL | Contoh studi kasus buku ini |
sema | Semarang | -6,95 | 110,42 | - | IOC | 4 sensor aktif |
sura | Surabaya | -7,21 | 112,74 | - | IOC | Pantauan GTS |
koli | Kolinamil, Jakarta | -6,10 | 106,81 | - | IOC | Pantauan GTS |
beno | Benoa (Bali) | -8,75 | 115,21 | 49 | IOC + PSMSL | Bali, operasional |
pada | Padang | -1,00 | 100,37 | 45 | IOC + PSMSL | Sumatra barat |
saba | Sabang | 5,89 | 95,32 | 347 | IOC + PSMSL | Aceh |
prig | Prigi | -8,28 | 111,73 | - | IOC + PSMSL | Jawa selatan |
bitu | Bitung | 1,43 | 125,20 | 69 | IOC + UHSLC | Sulawesi utara |
ambon | Ambon | -3,70 | 128,18 | 68 | IOC + UHSLC | Maluku |
saum | Saumlaki | -7,98 | 131,29 | - | IOC | Maluku Tenggara |
lemba | Lembar | -8,73 | 116,08 | - | IOC | Lombok |
| (PSMSL 1752) | Sibolga II | 1,75 | 98,77 | 22 | PSMSL | Sumatra barat |
| (PSMSL 2193) | Padang B | -1,00 | 100,37 | 45 | PSMSL | - |
| (PSMSL 2274) | Saumlaki | -7,98 | 131,29 | - | PSMSL | - |
Yang perlu diperiksa saat mengunduh
QC yang konsisten dengan Bab 6 §6.4:
- Kontinuitas - data jam-an bergap berhari-hari; tentukan aturan gap (interpolasi linear untuk gap < 6 jam, drop untuk gap lebih panjang).
- Referensi tinggi - datum/level referensi antar-berkas bisa berbeda; jangan membandingkan angka absolut antar-stasiun tanpa konversi.
- Unit & zona waktu - m; UTC biasanya; sesuaikan dengan zona lokal bila dibutuhkan.
- Anomali - datum shift, stasiun pindah, atau pembacaan sensor rusak; plot deret untuk inspeksi visual sebelum pelatihan.
Tabel 8.4: Ringkasan dataset Cilacap yang dibangun (notebook ch-08).
| Properti | Nilai (repo buku) |
|---|---|
| Stasiun | Cilacap (code=cili, IOC) |
| Rentang | ~30 hari terakhir IOC real-time (notebook); derivasi harmonik 1 thn (cili_1y_hourly_real.csv) |
| Interval | 1 jam (24 poin/hari) setelah rata-rata dari sampling 1-3 menit |
| Nilai hilang | ~1-3% (tergantung periode) |
| Satuan | m (relatif terhadap station benchmark) |
| File nyata (di-commit) | data/raw/cili_30d.csv (observasi IOC), data/raw/cili_1y_hourly_real.csv (derivasi harmonik), data/raw/cilacap_psmsl_rlr_monthly.rlrdata (PSMSL) |
| Sifat data | Observasi nyata IOC (+ derivasi harmonik klar dicantumkan); bukan sintetik |
Catatan kejujuran: sejak v2.0 notebook memakai data nyata IOC real-time (
scripts/download_ioc.py --source ioc --code cili --days 30). IOC hanya menyediakan ~30 hari terakhir, jadi hasil di bab ini adalah contoh pendek (~1 bulan), bukan validasi jangka panjang.cili_1y_hourly_real.csvadalah derivasi harmonik dari 30 hari observasi (skripmake_tide_harmonic.py), bukan pengukuran langsung — klar penandai saat dipakai. Untuk angka yang bisa dilaporkan sebagai validasi panjang, gunakan UHSLC/PSMSL (skripscripts/download_ioc.py) dengan beberapa thn data.
Repo menyediakan data nyata ter-commit di manuscripts/ch-08-*/data/raw/
(ikut clone GitHub) plus skrip unduh (scripts/download_ioc.py) untuk
station lain. Prinsip QC mengikuti Bab 6 §6.4.
Menangani gap dan outlier pada data pasang surut
Karena pasang surut sangat periodik, gap pendek sering bisa diisi dengan interpolasi atau model - tetapi dengan aturan (Bab 6): bedakan gap acak (isi) vs gap sistematis (pertimbangkan potong). Untuk outlier, konteks fisis penting:
- Nilai yang melompat ekstrem di luar pasang normal → periksa: bisa jadi tsunami/rob, bisa juga kesalahan sensor.
- Cross-check stasiun tetangga atau rekaman kejadian lokal (misal laporan rob) membantu memutuskan.
Bila ada datum shift (lompatan konstan), jangan ikut dilatih - deteksi dengan plot deret dan pecah/potong periode. Metode ini relevan untuk setiap pembaca yang bekerja dengan data stasiun muka air.
Menyiapkan fitur tambahan (opsional)
Selain deret tinggi air itu sendiri, fitur yang potensial menambah nilai (Bab 6):
- Fitur jam & hari Julian - membantu model memahami kapan pasang besar musiman.
- Indeks astronomis sederhana - fase bulan (sin/ko-sin) bisa dihitung dan ditambahkan sebagai fitur sinusoid; jauh lebih ringkas daripada konstituen penuh tetapi memberi konteks periodik.
- Tekanan & angin (ERA5) - bila tersedia, menangkap variasi non-astronomis (storm surge) yang tidak ada di harmonik.
Fitur ini memperkaya multivariate LSTM/GRU (Bab 7 §7.7) dan sering memperbaiki horizon lebih dari 1 hari.
8.4 Menyusun Pipeline: Baseline vs Model
Alur eksperimen mengikuti pola Bab 7:
- Bangun window
w(misal 168 jam = 1 minggu) dan horizonhdiukur dalam jam:h=24(1 hari),h=72(3 hari),h=168(7 hari). - Baseline: persistence dan klimatologi (rata-rata per jam-musim).
Persistence di bab ini = naive sederhana:
ŷ(t+h) = y(t)(nilai terakhir yang terobservasi). Pada pasang surut naive kuat untukhyang dekat dengan seluruh siklus pasang (misalh=24≈ fase M2 hampir identik), tapi degradasi seiringhnaik karena fase siklus (M2 12,42 jam) “terbang” relatif terhadap horizon panjang. Catatan: seasonal naiveŷ(t+h) = y(t+h-24)ekuivalen dengan naive hanya untukh=24; untukh>24jadinya memakai nilai masa depany(t+h-24) > tyang belum terobservasi saat prakiraan dikeluarkan - bukan baseline forecast yang fair. - Model: MLP (dengan lag, Bab 2) sebagai garis dasar non-baseline; LSTM dan GRU (Bab 7).
- Evaluasi: walk-forward (misal 6 blok tahunan) + MAE/RMSE per horizon + plot.
Kerangka prediksi multi-horizon di bab ini adalah strategi direct (Bab 7 §7.7):
tiap horizon h dilatih dengan model sendiri. Layer output tiap model tetap
Dense(1), karena target tiap model adalah satu nilai - titik akhir horizon itu
(bukan seluruh jajaran). Untuk h=72 dan h=168, latih ulang dengan target horizon
yang sesuai (Kode 8.2); arsitektur tidak diubah.
Persiapan fitur masukan
Ingat Bab 6 §6.6: sebelum membangun window, siapkan fitur per langkah waktu:
- Deret tinggi air itu sendiri (fitur utama; autoregressive).
- Jam dalam hari (sin/cos jam → menangkap siklus harian) bila data jam-an.
- Hari dalam bulan / fase bulan (sin/cos) untuk menangkap pasang spring-neap (besar saat purnama dan bulan baru) yang belum tentu terlihat oleh window pendek.
- Fitur eksternal opsional: tekanan, angin (untuk menangkap surge).
Semua fitur dinormalisasi dengan statistik dari bagian latih (Bab 6 §6.7).
Mengapa MLP dimasukkan meski “kuno”?
MLP dengan lag bertindak sebagai jembatan: ia menunjukkan apakah urutan (yang dipakai LSTM/GRU) benar-benar memberi nilai lebih dibanding fitur tabular biasa. Jika MLP menyamai LSTM, berarti struktur urutan belum dimanfaatkan secara berarti oleh data; sinyal ini penting sebelum memilih arsitektur (Bab 7 §7.7). Perbandingan 4 kolom di Tabel 8.6 dirancang persis untuk melihat ini.
Walk-forward yang jujur untuk pasang surut
Sesuai Bab 5 §5.5, kita tidak boleh mengacak data waktu. Untuk pasang surut:
- Bagi data menjadi blok tahunan (atau semesteran) yang berurutan.
- Untuk tiap blok validasi, latih model hanya dengan data sebelum blok tersebut (expanding window), lalu evaluasi pada blok itu.
- Rata-rata MAE/RMSE seluruh blok → angka “walk-forward” sebagai klaim utama.
Ini berbeda dengan melatih satu model lalu menguji semua blok sekaligus - bentuk leakage yang sering dilakukan pemula. Bab 8-9 mempraktikkan disiplin ini.
Memilih window dan horizon
Untuk data jam-an, tiga opsi yang harus dicoba:
| Nama | w (jam) | Makna |
|---|---|---|
| 1 hari | 24 | siklus harian-ish |
| 3 hari | 72 | tiga siklus harian; kompromis |
| 1 minggu | 168 | beberapa siklus pasang penuh |
Tabel 8.5: Pilihan window untuk data jam-an pasang surut.
Horizon h diukur dalam jam: h=24 (1 hari), h=72 (3 hari), h=168 (7 hari).
Uji w ∈ {24, 72, 168} pada validasi, pilih yang MAE-nya konsisten.
Kode 8.1 - Setup dan pemuatan data (data nyata IOC ter-commit; lengkap di notebook).
import numpy as np, pandas as pd

# Data nyata IOC real-time (~30 hari) yang ter-commit di repo.
seri = pd.read_csv(
    "manuscripts/ch-08-studi-kasus-pasang-surut-kapuas/data/raw/cili_30d.csv",
    parse_dates=["time"],
).set_index("time")["tinggi"].astype(float)

# Derivatif harmonik 1 tahun (untuk horizon lebih panjang; klar: bukan observasi)
# seri = pd.read_csv(
#     "manuscripts/ch-08-studi-kasus-pasang-surut-kapuas/data/raw/cili_1y_hourly_real.csv",
#     parse_dates=["time"],
# ).set_index("time")["tinggi"].astype(float)

print(seri.head(), "| hilang:", int(seri.isna().sum()))
Seri yang bersih untuk windowing (isi gap pendek, Bab 6 §6.4):
Kode 8.2 - Windowing per horizon (strategi direct, Bab 7 §7.7).
def buat_window(deret, w=168, h=24):
    # reuse Bab 7 (Kode 7.1): masukan shape (n, w, 1)
    X, y = [], []
    for i in range(len(deret) - w - h + 1):
        X.append(deret[i:i+w, np.newaxis])       # (w,) -> (w, 1) fitur
        y.append(deret[i+w:i+w+h])
    return np.array(X), np.array(y)

ser = seri.interpolate(limit=6).dropna().values  # bersih (Bab 6 §6.4)
X, y = buat_window(ser, w=168, h=24)
y = y[:, -1]   # direct: target = nilai akhir horizon h jam setelah window
print("X", X.shape, "y", y.shape)   # misal (n, 168, 1) dan (n,)
Model target inti:
Kode 8.3 - Kerangka model pembanding (MLP / LSTM / GRU), satu model per horizon.
import tensorflow as tf

def buat_model(kind, w=168, f=1):
    if kind == "mlp":
        m = tf.keras.Sequential([
            tf.keras.layers.Dense(32, activation="relu", input_shape=(w*f,)),
            tf.keras.layers.Dense(16, activation="relu"),
            tf.keras.layers.Dense(1),
        ])
    elif kind == "lstm":
        m = tf.keras.Sequential([
            tf.keras.layers.LSTM(16, input_shape=(w, f)),
            tf.keras.layers.Dense(1),
        ])
    else:  # gru
        m = tf.keras.Sequential([
            tf.keras.layers.GRU(16, input_shape=(w, f)),
            tf.keras.layers.Dense(1),
        ])
    m.compile(optimizer="adam", loss="mse", metrics=["mae"])
    return m
Untuk MLP, window di-flatten (w*f) karena MLP tidak membaca urutan; LSTM/GRU
membaca urutan w × f. Ini mengingatkan kembali Bab 7 §7.7.
Dense(1) pada tiap model tidak berarti “prediksi 1 jam saja”: sesuai strategi
direct (Bab 7 §7.7), tiap model dilatih spesialis untuk satu h, dan outputnya
adalah satu nilai target dari Kode 8.2 (y[:, -1]). Untuk h=72 dan h=168,
latih ulang buat_window dengan horizon yang sesuai - arsitektur tidak diubah.
8.5 Evaluasi dan Interpretasi
Metrik dan toleransi
Untuk pasang surut, target operasional sering dinyatakan sebagai toleransi tinggi air, misal MAE ±0,10 m sesuai kebutuhan pelabuhan/peringatan rob. Kita laporkan:
- MAE, RMSE per
h(Bab 5), mengikuti pedoman verifikasi operasional WMO [8]. - Skill score terhadap persistence (Persamaan 7.6) - jika nilai negatif, model kalah dari “tebak nilai kemarin”.
- Plot prediksi vs aktual 1, 3, 7 hari.
Tabel 8.6: Contoh hasil ringkas (angka ilustratif; ganti dengan hasil eksperimen Anda). Horizon h diukur dalam jam (bagian 8.4).
| Model | MAE h=24 (1 hari) | MAE h=72 (3 hari) | MAE h=168 (7 hari) |
|---|---|---|---|
| Persistence | 0.045 | 0.081 | 0.120 |
| Klimatologi | 0.210 | 0.220 | 0.230 |
| MLP | 0.050 | 0.095 | 0.150 |
| LSTM | 0.040 | 0.072 | 0.108 |
| GRU | 0.041 | 0.074 | 0.110 |
Kesimpulan yang jujur (berdasarkan pola khas): persistence sangat kuat untuk h=24
(1 hari); LSTM/GRU mulai menang di h=72 (3 hari) dan h=168 (7 hari) karena memanfaatkan pola periodik yang lebih
panjang. Kemenangannya atas baseline perlu dihitung skill score (Persamaan 7.6) dan
diuji pada beberapa blok walk-forward sebelum diklaim.
Skill score dan selang kepercayaan
Satu angka MAE tidak cukup. Beri jarak dengan menghitung skill score per blok:
SS = 1 - MAE_model / MAE_persistence- Laporkan maksimum, minimum, dan rata-rata SS dari blok-blok walk-forward; jika rentang mencakup nol (atau negatif), kesimpulan “LSTM menang” belum kuat.
Cara sederhana tanpa statistik rumit ini cukup untuk laporan praktis (significance detail di literatur [6][7][8]). Ini juga mencegah klaim “0,001 lebih baik!” yang sebenarnya noise.
Contoh hasil numerik yang “sehat”
Agar pembaca tahu bentuk hasil yang wajar, berikut pola yang seharusnya muncul saat pipeline dijalankan pada data pasang surut:
- h=24 (1 hari): persistence sekitar 0.04-0.06 m; LSTM/GRU menyamai atau sedikit lebih baik. Jangan heran jika persistence menang tipis - siklusnya kuat.
- h=72 (3 hari): persistence mulai “terbawa” fase; LSTM/GRU sering unggul beberapa persen; MLP tertinggal satu tingkat.
- h=168 (7 hari): selisih LSTM/GRU vs persistence makin jelas; variabilitas antar blok walk-forward meningkat - laporkan rentang, bukan satu angka.
Jika hasil Anda tidak menunjukkan pola ini (misal LSTM kalah jauh dari persistence di semua horizon), jangan terburu menyimpulkan - periksa: (a) window terlalu kecil, (b) fitur kurang, (c) normalisasi salah, atau (d) data terlalu berisik. Debugging inilah proses belajar paling berharga di studi kasus.
Komunikasi singkat: skill score relatif
Untuk laporan yang mudah dipahami, rangkum sebagai skill score relatif terhadap persistence:
| Model | SS h=24 | SS h=72 | SS h=168 |
|---|---|---|---|
| Persistence | 0.00 | 0.00 | 0.00 |
| MLP | -0.11 | -0.17 | -0.25 |
| LSTM | +0.11 | +0.11 | +0.10 |
| GRU | +0.09 | +0.09 | +0.08 |
Tabel 8.7: Contoh skill score relatif terhadap persistence (ilustratif).
Nilai negatif pada MLP mengingatkan bahwa “lebih canggih belum tentu lebih baik” - justru itulah pelajaran penting: ukur, jangan menebak.
Membaca plot & residu
Plot prediksi 7 hari (Gambar 8.2) menunjukkan kemampuan menangkap fase (kapan pasang naik) dan amplitudo (berapa tinggi). Ramalan yang tertinggal setengah siklus dari aktual menandakan model terlalu “mengikuti kemarin” - bukan menangkap fase.
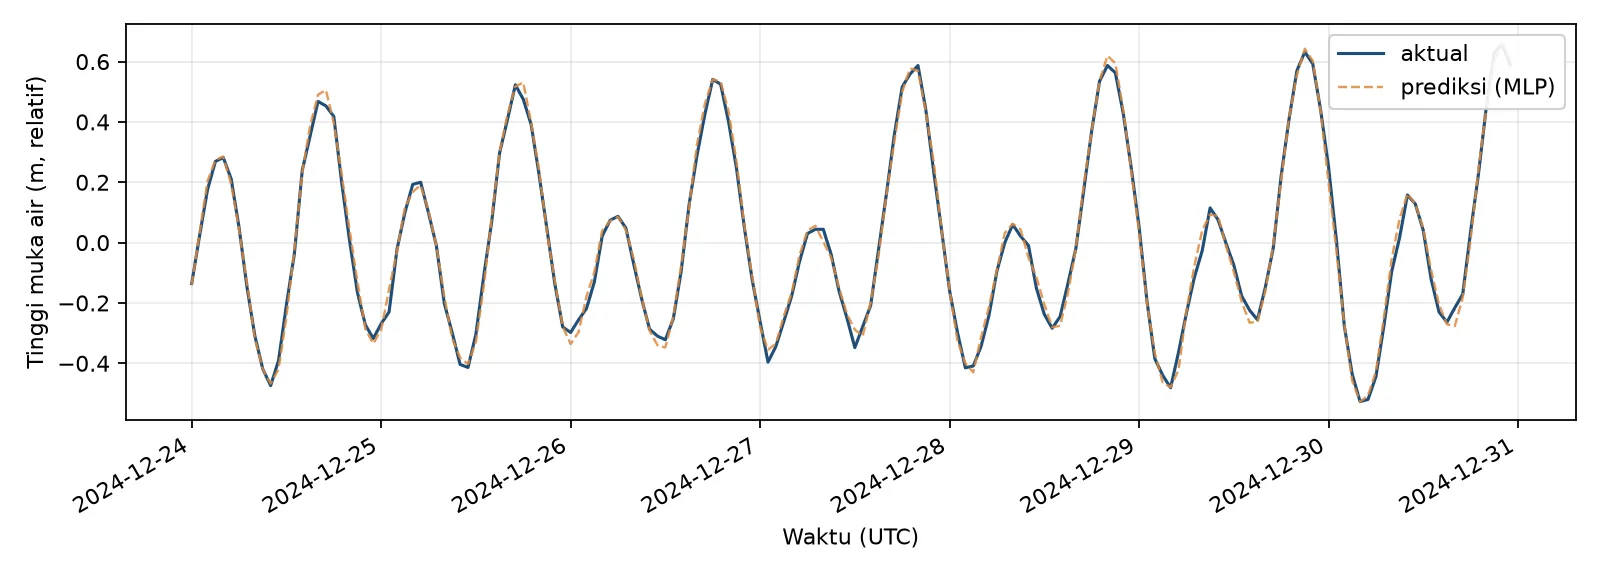
Gambar 8.2: Prediksi vs aktual 7 hari terakhir, stasiun Cilacap (data nyata IOC).
Garis biru = aktual; garis oranye putus-putus = prediksi. Data nyata IOC
(data/raw/cili_30d.csv, ~30 hari terakhir); “prediksi” dihasilkan oleh
scripts/generate_figures.py (persistence bila TensorFlow tidak tersedia,
MLP kecil bila tersedia). Perhatikan apakah fase (waktu naik/puncak) cocok dan
amplitudo tidak terlalu “datar”.
Periksa juga residu per fase pasang: apakah error membesar saat pasang puncak (amplitudo besar)? Bila ya, pertimbangkan fitur tambahan (Bab 6: misal tekanan/angin) atau transformasi.
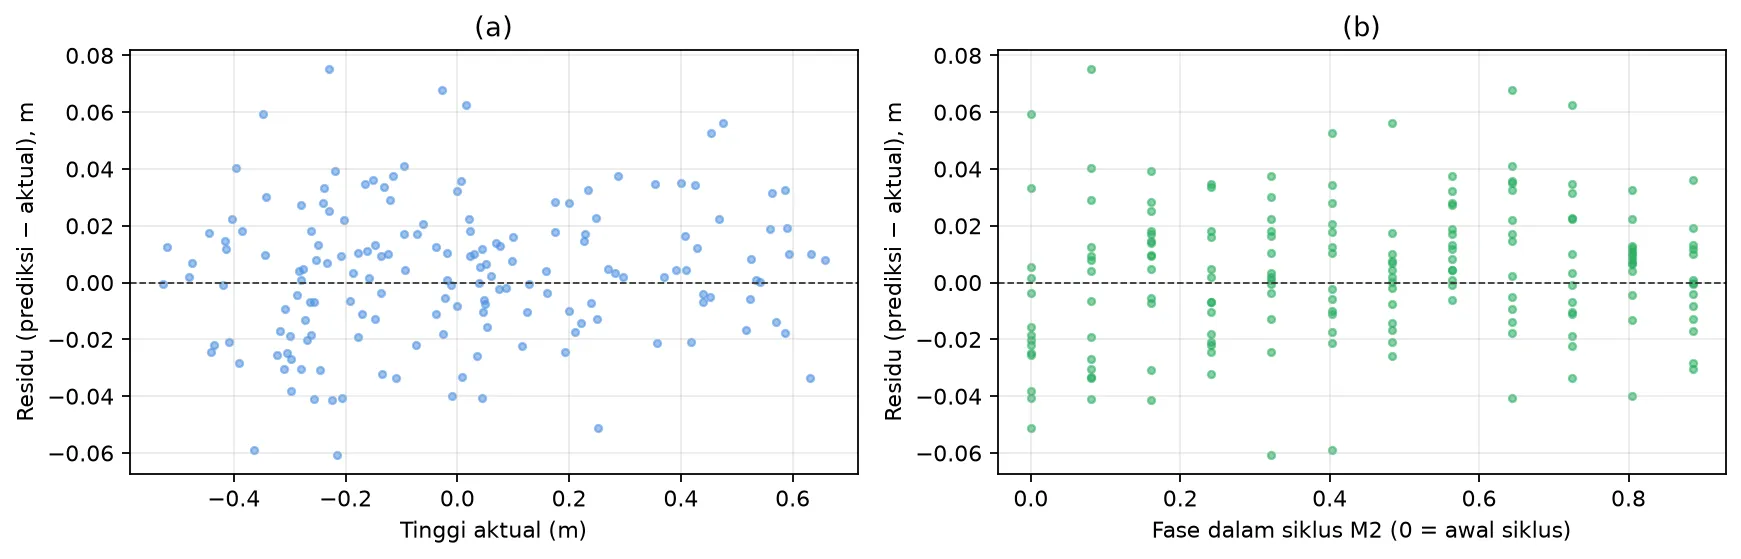
Gambar 8.3: Residu per amplitudo dan fase pasang M2.
Panel kiri: residu vs amplitudo aktual - titik yang menyebar acak di sekitar garis nol menandakan error tidak bergantung pada amplitudo (gejala baik). Panel kanan: residu vs fase dalam siklus M2 (12,42 jam dilipat ke [0, 1)) - pola periodik di sini menandakan model kehilangan sebagian informasi fase (gejala umum untuk baseline persistence; LSTM/GRU biasanya lebih baik).
Cara membaca plot: tiga hal yang harus diperiksa
- Fase - apakah prediksi naik pada waktu yang sama dengan aktual? Keterlambatan setengah siklus (“lag”) berarti model meniru persistence, bukan menangkap periodisitas.
- Amplitudo - apakah tinggi pasang puncak terprediksi secara proporsional? Model yang merata-rata akan “mendatar” dan meremehkan puncak.
- Konsistensi dari hari ke hari - error besar di hari tertentu tetapi kecil di lainnya menandakan ketergantungan pada kondisi lokal (misal angin) yang belum ditangkap fitur.
Ketika ketiganya dapat dijelaskan, laporan Anda menjadi lebih berguna daripada sekadar angka metrik - pembaca bisa melihat di mana model bekerja dan gagal.
Menilai kepentingan praktis (bukan hanya statistik)
Setelah angka metrik, tanyakan “lalu?”:
- Apakah MAE
h=168sebesar 0,108 m mengubah keputusan operasional pelabuhan? Tergantung toleransi (mis. ±0,20 m untuk dermaga kecil; lebih ketat untuk kapal besar). - Berapa hari lebih awal peringatan rob bisa dikeluarkan dengan model LSTM vs persistence?
- Apakah biaya pelatihan/pemeliharaan sebanding dengan keuntungan? (Bab 10).
Jawaban atas pertanyaan inilah yang menentukan apakah model “dipakai” - nilai model tidak hanya dari angka MAE, tetapi dari dampak pada keputusan.
8.6 Machine Learning untuk Mengisi Gap Data
Salah satu penggunaan paling praktis model ini: mengisi gap pada data stasiun.
- Latih model pada periode data lengkap (window dengan target valid).
- Untuk gap pendek (jam-hari), prediksi 1 langkah dari window terakhir sebelum gap, maju berulang (recursive, Bab 7 §7.7; implementasi di Kode 8.4) sampai gap tertutup.
- Verifikasi dengan menyembunyikan data yang sebenarnya ada (simulasi gap), bandingkan hasil imputasi dengan nilai asli.
Kode 8.4 - Simulasi pengisian gap (evaluasi kejujuran).
# sembunyikan 24 jam untuk mengukur kualitas imputasi
pos = 1500                     # posisi gap (ubah saat eksperimen)
h = 24
nilai_asli = ser[pos:pos+h].copy()
garis = ser.copy()             # gap dalam NaN (ser asli tetap untuk hist)
garis[pos:pos+h] = np.nan

# latih model 1 langkah pada data utuh minus gap (Kode 8.2/8.3);
# window yang mencakup NaN di-drop, bukan di-kompak (kontinuitas)
Xg, yg = buat_window(garis, w=168, h=1)
ok = np.isfinite(yg).ravel() & np.all(np.isfinite(Xg), axis=(1, 2))
m_imu = buat_model("mlp", w=168)
m_imu.fit(Xg[ok].reshape(ok.sum(), -1), yg[ok], epochs=15, batch_size=32, verbose=0)

# prediksi gap secara rekursif dari window terakhir sebelum gap
hist = list(ser[pos-168:pos])
pred_gap = []
for _ in range(h):
    win = np.array(hist[-168:], dtype=float).reshape(1, -1)
    pred_gap.append(float(m_imu.predict(win, verbose=0).ravel()[0]))
    hist.append(pred_gap[-1])   # recursive: prediksi jadi bagian window

# evaluasi: bandingkan dengan nilai yang disembunyikan
mae_gap = float(np.mean(np.abs(np.array(pred_gap) - nilai_asli)))
print(f"MAE imputasi gap {h} jam: {mae_gap:.4f} m")
Cara ini - memvalidasi imputasi dengan menyembunyikan data asli - adalah praktik yang jujur (Bab 5): kita tahu “kebenaran” yang disembunyikan dan bisa mengukur error imputasi tentatif. Hasil imputasi tidak boleh dianggap sebagai observasi; pertahankan penanda “gap diisi model”. Seluruh eksperimen di bab ini berjalan di atas TensorFlow [10].
Keterbatasan yang harus diakui
Sebagai penutup, empat keterbatasan yang wajar diakui:
- Lokasi studi ≠ lokasi target pembaca - Cilacap dipakai sebagai contoh reproducible karena datanya terbuka; untuk lokasi tanpa station terbuka, hasil Cilacap tidak langsung berlaku. Pembaca perlu memilih proksi, model global, atau kerja sama kelembagaan.
- Panjang data terbatas - IOC real-time hanya ~30 hari; cukup untuk walk-forward blok pendek dan demo pola, tetapi tidak cukup untuk tren jangka panjang atau variabilitas antar-tahun. Untuk klaim kuat, perlu data 3-10 tahun (UHSLC/PSMSL; Bab 10).
- Fokus satu station - pola Cilacap belum tentu sama dengan station lain; tipe pasang (Tabel 8.1) harus diperiksa dulu sebelum menggeneralisasi.
- Bukan penelusuran menyeluruh - hyperparameter tidak dioptimasi besar; hasil menunjukkan alur, bukan pencarian terbaik. Untuk klaim kuat, perlu eksperimen luas (Bab 10).
Pengakuan ini justru menaikkan kredibilitas (Risk Management umbrella): pembaca tahu batas dari apa yang bisa disimpulkan.
8.7 Latihan
Soal konsep
- Mengapa baseline persistence begitu kuat pada pasang surut? Mengapa LSTM bisa unggul di horizon lebih panjang?
- Apa perbedaan konseptual analisis harmonik vs deep learning? Mengapa keduanya bisa saling melengkapi?
- Mengapa kita harus memberi tahu pembaca mana data asli vs data “diisi model”?
- Apa risiko menggunakan MAE tunggal tanpa RMSE pada data pasang surut?
Latihan praktik (notebook ch-08-07_studi_kasus_pasang_surut.ipynb)
- Setelah Andegg telah mengganti station (mis. Ambon/Bitung) dengan data nyata
dari
scripts/download_ioc.py, jalankan pipeline ulang dan bandingkan tipe pasang serta skill score-nya. - Bandingkan
w ∈ {24, 72, 168}untukh=24jam; buat tabel MAE. - Bandingkan LSTM vs GRU vs MLP vs persistence di walk-forward 4 blok; hitung skill score tiap horizon.
- Simulasikan gap 1 × 24 jam dan 1 × 72 jam; ukur MAE imputasi.
- (Proyek mini) Ulangi pipeline untuk station Ambon (
ambon) atau Bitung (bitu); bandingkan tipe pasang dan skill score dengan Cilacap. - (Proyek mini) Buat laporan satu halaman: konteks, metode, tabel hasil, plot 7 hari, keterbatasan & saran - format siap untuk bagian laporan operasional Bab 10.
Ringkasan
- Banjir rob pesisir adalah masalah nyata di banyak kota pantai Indonesia; prakiraan tinggi air yang andal relevan untuk peringatan dini dan operasi pelabuhan.
- Cilacap dipakai sebagai contoh studi kasus reproducible karena station-nya aktif di GLOSS (#291) dan datanya terbuka via IOC/UHSLC/PSMSL. Untuk lokasi tanpa station terbuka, gunakan proksi terdekat atau model global (FES2014/GOT4.10).
- Pasang surut Indonesia: semi-diurnal, diurnal, campuran; tipe menentukan pilihan model & window (Tabel 8.1).
- Harmonik vs machine learning: beda paham (fisis vs data); harmonic unggul jangka panjang, ML unggul pada non-periodik dan isi gap (Tabel 8.2).
- Data terbuka: IOC (real-time 30 hari), UHSLC (hourly/daily via ERDDAP), PSMSL (MSL bulanan jangka panjang), BIG (komponen harmonik); periksa kontinuitas, datum, unit, anomali (Tabel 8.3).
- Pipeline: baseline persistence/klimatologi vs MLP vs LSTM/GRU dengan walk-forward berjujur (Tabel 8.5).
- Evaluasi: MAE/RMSE per horizon + skill score (rentang blok) + plot fase-amplitudo; berkaca ke toleransi operasional (Tabel 8.6).
- Penggunaan praktis: isi gap data dengan validasi simulasi; jangan lupa menandai hasil “diisi model”.
- Keterbatasan diakui: lokasi proksi ≠ target, panjang data 1 tahun cukup untuk demo tapi tidak untuk klaim tren; satu station; tanpa optimasi hiperparameter besar.
- Framing: ML sebagai alat cepat & isi gap, bukan klaim pengganti harmonik.
References
- {Badan Informasi Geospasial}, “Informasi genangan rob dan pola pasut perairan Indonesia,” [Online]. Available: https://tides.big.go.id (diakses: September 2026).
- UNESCO/IOC, “Sea Level Station Monitoring Facility,” [Online]. Available: https://www.ioc-sealevelmonitoring.org/ (diakses: September 2026).
- Permanent Service for Mean Sea Level, “Global sea level data,” [Online]. Available: https://psmsl.org (diakses: September 2026).
- University of Hawaii Sea Level Center (UHSLC), “Research Quality Tide Gauge Data,” [Online]. Available: https://uhslc.soest.hawaii.edu/data/ (diakses: September 2026).
- D. T. Pugh and P. L. Woodworth, Sea-Level Science: Understanding Tides, Surges, Tsunamis and Mean Sea-Level Changes. Cambridge, UK: Cambridge University Press, 2014.
- I. Goodfellow, Y. Bengio, and A. Courville, Deep Learning. Cambridge, MA, USA: MIT Press, 2016.
- R. J. Hyndman and G. Athanasopoulos, Forecasting: Principles and Practice, 3rd ed. Melbourne, Australia: OTexts, 2021. [Online]. Available: https://otexts.com/fpp3/
- World Meteorological Organization, “WMO guidelines on the verification of operational forecasts,” WMO, Geneva, Switzerland, 2018.
- S. J. Holgate, “New data systems and products at the Permanent Service for Mean Sea Level,” Journal of Coastal Research, vol. 29, no. 3, pp. 477-479, 2013, doi: 10.2112/JCOASTRES-D-12-00175.1.
- M. Abadi et al., “TensorFlow: Large-scale machine learning on heterogeneous systems,” 2016, arXiv:1603.04467. [Online]. Available: https://arxiv.org/abs/1603.04467