 Kanada Kurniawan
Bab 9 - Studi Kasus: Prediksi Curah Hujan dengan Data Terbuka
Prasyarat: Bab 2-7 (regresi, klasifikasi, evaluasi, data, LSTM/GRU) dan Bab 8 (alur studi kasus end-to-end). Bab 9 menggabungkan dua lintasan - regresi dan klasifikasi - pada satu target operasional.
Catatan: Materi bab ini adalah materi pengenalan, bukan hasil riset baru. Seluruh isi merupakan ringkasan ulang literatur machine learning, dengan contoh-contoh yang dekat dengan dunia meteorologi Indonesia.
Tujuan Pembelajaran
Setelah menyelesaikan bab ini, Anda diharapkan mampu:
- Membangun prediktor hujan harian titik grid terbuka (regresi jumlah hujan + klasifikasi intensitas) dengan fitur regional ERA5/ERA5-Land dan indeks iklim.
- Menerapkan verifikasi operasional dengan CSI/POD/FAR dan trade-off threshold.
- Membandingkan walk-forward vs baseline (persistence, klimatologi, ARIMA singkat).
- Melakukan interpretasi awal (permutation importance; SHAP penuh di Bab 10) dan menyusun tabel verifikasi per kategori intensitas.
9.1 Konteks Pelayanan dan Kejujuran Framing
CHIRPS adalah dataset curah hujan harian global (grid ±0,05° ≈ 5 km) yang digabungkan dari satelit dan stasiun, tersedia bebas untuk diunduh [1]. Studi kasus ini memakai data serupa yang sepenuhnya terbuka (CHIRPS, ERA5/ERA5-Land, indeks iklim) agar pembaca dapat mereproduksi tanpa akun atau izin khusus. Dampak prediksi curah hujan langsung menyentuh masyarakat, sehingga kehati-hatian dan kejujuran dalam klaim menjadi keharusan - bukan sekadar etika, tetapi juga pelindung kredibilitas.
Tiga hal yang harus ditegaskan sejak awal (sejalan dengan Risk Management umbrella):
- Materi pengenalan, bukan hasil riset resmi. Studi kasus ini adalah latihan end-to-end yang dapat diulang pembaca, bukan klaim sebagai sistem operasional institusi mana pun.
- Hujan sulit diprediksi. Nilai harian bersifat berisik dan banyak nol; ekspektasi harus realistis. Skill score (Bab 7 Persamaan 7.6) terhadap baseline adalah cara jujur untuk melaporkan.
- Data yang dipakai harus disebutkan. Jenis data (grid/pelengkap), rentang, lisensi, dan versi dicatat (Bab 6 §6.9) agar hasil dapat diperiksa ulang.
Seperti Bab 8, framing “alat bantu yang dapat dijelaskan” lebih tepat daripada “menggantikan peramal”. Nilai utama studi kasus: menunjukkan alur dan metrik yang benar, bukan meyakinkan bahwa deep learning selalu unggul.
9.2 Data: Titik Grid CHIRPS + Fitur Regional
Untuk model hujan, strategi data (Bab 6) berbentuk:
- Target: curah hujan harian titik grid CHIRPS [1] (misal satu titik di wilayah barat dan satu di wilayah timur Indonesia untuk perbandingan pola).
- Fitur lokasi: hujan kemarin (lag), suhu, kelembapan, angin - dari grid terbuka (ERA5-Land/ERA5) atau stasiun GHCND bila ingin verifikasi berbasis observasi.
- Fitur regional (ERA5/ERA5-Land) [2][3]: suhu, angin, kelembapan,
total precipitationpada grid terdekat - memberi konteks atmosfer yang tidak tercatat di titik target. - Indeks iklim: ENSO (Nino3.4 anomali SST dari NOAA PSL [6]; MEI [5] sebagai alternatif - tidak dipakai bersamaan untuk menghindari redundansi) dan MJO (RMM1, RMM2 [4]) - berpengaruh pada hujan Indonesia.
Tabel 9.1: Ringkasan fitur yang dibangun untuk satu titik lokasi.
| Kelompok | Contoh fitur | Sumber |
|---|---|---|
| Deret tunda | hujan_t1, hujan_t2, hujan_t3, hujan_t7 | CHIRPS [1] |
| Observasi lokal (verifikasi opsional) | suhu_t1, gur_rh_t1 (lag 1) | ERA5-Land [2][3] |
| Regional grid | era5_tp_t1, era5_u10_t1, era5_v10_t1, era5_t2m_t1 (lag ≥ 1 hari) | ERA5/ERA5-Land [2][3] |
| Musiman | mus_sin, mus_cos | dihitung |
| Indeks iklim | rmm1, rmm2, nino34 | BoM/NOAA PSL [4][6] |
Catatan ERA5: ERA5 adalah reanalysis, bukan forecast operasional. Semua fitur ERA5 di-lag minimal 1 hari terhadap target (Tabel 9.1), karena data ERA5 hari D belum tersedia saat prediksi D+1 harus dibuat. ERA5 final punya latency beberapa bulan, sedangkan ERA5T (near-real-time) sekitar 5 hari; studi kasus ini bersifat historis, tidak klaim sistem operasional real-time. Lag ini justru mencegah leakage: fitur ERA5 hari D hanya dipakai untuk prediksi hujan D+1.
Satuan ERA5: total_precipitation (tp) dalam meter, akumulasi per jam. Konversi ke mm
(tp * 1000), lalu agregasi harian sesuai definisi “hari” yang konsisten antara fitur
dan target:
df["era5_tp_mm"] = df["era5_tp"] * 1000.0        # meter -> mm
df["era5_tp_harian"] = df["era5_tp_mm"].resample("24h", offset="7h").sum()
Lisensi data: semua sumber terbuka - CHIRPS (domain publik, kutip Funk et al. 2015 [1]), ERA5/ERA5-Land di bawah Copernicus Climate Data Store license [2][3], NOAA/BoM dengan attribution sesuai sumber (Bab 6 §6.9). Tidak ada data berizin/rahasia yang dipakai.
Semua fitur dinormalisasi dengan statistik dari bagian latih saja (Bab 6 §6.7); target
regresi di-transform log1p bila dipakai (Bab 6 §6.7).
Data multi-titik: barat vs timur Indonesia
Pola hujan Indonesia sangat bergantung pada geografi: wilayah barat (Sumatera, Kalimantan, Jawa) dipengaruhi kuat oleh monsun Asia-Australia dan MJO; wilayah timur (Papua, Maluku, Nusa Tenggara Timur) lebih dipengaruhi oleh monsun Australia dan variabilitas ENSO. Untuk studi kasus yang lebih lengkap, bandingkan dua titik grid berbeda pola:
- Titik barat (misal sekitar Kalimantan atau Jawa): hujan sepanjang tahun dengan puncak musiman; variabilitas hari-ke-hari tinggi.
- Titik timur (misal sekitar Papua atau Nusa Tenggara Timur): musim kering lebih tegas saat monsun Australia; dampak El Niño jauh terasa.
Dengan dua titik ini, pembaca bisa melihat bahwa:
- Fitur yang relevan berbeda antar wilayah (MJO penting di barat; Nino3.4 lebih menonjol di timur).
- Model yang sama tidak otomatis transfer antar wilayah - perlu dilatih ulang.
- Evaluasi harus dilakukan per lokasi; rata-rata antar lokasi bisa menyembunyikan kegagalan lokal.
Notebook menyediakan dua rangkaian data contoh (sintetik dengan pola berbeda) dan
meminta Anda mengganti dengan data nyata titik pilihan (via scripts/download_chirps.py
dan scripts/download_era5.py).
Frekuensi dan resolusi data
Data hujan harian (stasiun maupun grid CHIRPS) umumnya tersedia sebagai kumulatif 24 jam - pastikan Anda konsisten dengan definisi “hari” pada target dan fitur. Untuk CHIRPS, raster harian adalah total 24 jam; untuk stasiun, perhatikan jam pengamatan (misal 07.00-07.00 lokal). Bila data jam-an tersedia, Anda bisa agregasi ke harian (sum/resample) atau justru membangun prediksi sub-harian (di luar lingkup buku ini). Konsistensi definisi waktu mencegah leakage halus: jangan mencampur jam-an dan harian tanpa transformasi yang jelas.
9.3 Dua Lintasan: Regresi dan Klasifikasi
Bab 2-3 mengajarkan keduanya; di sini kita terapkan pada masalah yang sama, karena kebutuhan operasionalnya keduanya ada.
- Lintasan regresi: prediksi jumlah mm hujan besok. Metrik: MAE, RMSE (Bab 5);
transformasi
log1pmembantu (Bab 6). - Lintasan klasifikasi: prediksi kategori intensitas hujan harian. Mengikuti ambang umum intensitas hujan, ringkas menjadi 3 kelas (Tabel 9.2):
Tabel 9.2: Kategori intensitas hujan harian (mm/24 jam) yang dipakai.
| Kategori | Rentang (mm/24 jam) | Label |
|---|---|---|
| Tidak hujan / ringan | < 20 | 0 |
| Sedang | 20 - <50 | 1 |
| Lebat / sangat lebat | ≥ 50 | 2 |
Catatan: Tabel 9.2 mengelompokkan ambang umum menjadi 3 kelas: kelas 0 mencampur tidak hujan (0 mm) dan hujan ringan (>0-<20 mm); kelas 2 mencampur lebat dan sangat lebat (≥50 mm). Jika kebutuhan operasional meminta lebih fin, skema yang lebih lengkap punya “tidak hujan” dan “sangat lebat” terpisah.
Untuk klasifikasi biner “hujan lebat vs tidak” (untuk peringatan dini), gunakan ambang
≥ 50 sebagai kelas positif (lebat atau sangat lebat); evaluasi dengan metrik fenomena
langka (Bab 5): CSI, POD, FAR dan trade-off threshold (Bab 3).
Model yang dipakai: GRU multivariate (Bab 7) sebagai pilihan utama; MLP + lag sebagai
pembanding; LSTM bila perlu. Seluruh model dilatih dengan window w (misal 7-30 hari)
tanpa shuffle - urutan window dipertahankan agar tiap blok walk-forward tetap
kronologis dan perbandingan antar blok adil. (Bab 7 §7.9 mencatat bahwa shuffle=True
umumnya aman untuk model stateless; di sini kita memilih tanpa shuffle demi
keseragaman antar blok.)
Mengapa dua lintasan, bukan satu?
Regresi dan klasifikasi menjawab pertanyaan operasional yang berbeda:
- Regresi menjawab “berapa mm?” - berguna untuk pengelola lahan, drainase, studi hidrologi.
- Klasifikasi menjawab “hujan lebat atau tidak?” - berguna untuk peringatan dini dan keselamatan.
Mereka juga berperilaku berbeda: regresi sering “mendatar” pada nilai tengah (sulit memprediksi angka besar), sedangkan klasifikasi memberi kebebasan threshold (POD/FAR tunable). Mengerjakan keduanya sekaligus menunjukkan bahwa satu masalah operasional bisa dipotong menjadi beberapa masalah machine learning yang berbeda - keterampilan perancangan yang penting (Bab 1 §1.8 melatih ini).
Menangani data tak seimbang pada klasifikasi hujan lebat
Hujan lebat (≥50 mm) hanya terjadi beberapa hari dalam setahun di sebagian besar lokasi. Strategi yang dipakai (Bab 3 §3.6):
- Metrik yang tepat (CSI/POD/FAR, bukan akurasi).
class_weightpada training (Kode 3.3) - penalti lebih besar untuk kesalahan pada kelas lebat.- Threshold digeser saat inferensi (Bab 9.4) - tuning “sisi keputusan” tanpa melatih ulang.
Catatan: class_weight mengubah distribusi yang “dilihat” model, jadi angka POD/FAR
harus dievaluasi dengan data asli (tidak seimbang) - jangan mengevaluasi pada data yang
sudah di-resample.
Peringatan khusus deret waktu: hindari oversampling acak (mis. SMOTE) pada data
hujan harian. Menyalin atau mensintesis contoh secara acak merusak kontinuitas temporal
(window “baru” bisa berisi hari yang sama dari masa depan) dan membuat evaluasi bocor.
Untuk deret waktu, class_weight (Bab 3 §3.6) dan pergeseran threshold (Bab 9.4)
jauh lebih aman daripada resampling.
9.4 Verifikasi Operasional: CSI/POD/FAR dan Threshold
Inilah bagian yang membedakan bab ini dengan tutorial ML umum. Setelah probabilitas (dari sigmoid/softmax) didapat, kita tidak otomatis memakai threshold 0,5 - kita menggesernya sesuai prioritas operasional (Bab 3 §3.7).
Catatan: threshold relevan untuk klasifikasi biner (sigmoid); untuk multi-kelas
softmax, keputusan diambil dengan argmax, bukan threshold 0,5 - geser threshold
hanya pada biner atau one-vs-rest.
Kode 9.1 - Verifikasi CSI/POD/FAR di banyak threshold.
def verifikasi(y_true, prob, thresholds):
    baris = []
    for t in thresholds:
        y_pred = (prob >= t).astype(int)
        tp = int(((y_pred==1) & (y_true==1)).sum())
        fp = int(((y_pred==1) & (y_true==0)).sum())
        fn = int(((y_pred==0) & (y_true==1)).sum())
        pod = tp/(tp+fn) if (tp+fn) else 0
        far = fp/(tp+fp) if (tp+fp) else 1
        csi = tp/(tp+fp+fn) if (tp+fp+fn) else 0
        baris.append((t, pod, far, csi))
    return baris
Memilih threshold secara sistematis
Ada beberapa cara memiliki titik kerja yang bisa dijelaskan:
- Cost matrix - tetapkan harga miss vs false alarm (misal 5:1 untuk peringatan dini), lalu pilih threshold yang meminimalkan total biaya pada validasi.
- Target keberhasilan - misal “POD ≥ 0,7 dengan FAR ≤ 0,5”; pilih threshold terkecil yang memenuhi keduanya.
- Jawab pertanyaan pemangku - tanyakan “lebih buruk mana: peringatan keliru atau kejadian terlewat?” dan biarkan jawaban menentukan titik kerja.
Ketiga pendekatan lebih baik daripada “ambil CSI maksimal” karena mengikutsertakan konteks operasional - bukan hanya statistik. Laporkan threshold yang dipilih dan alasan pemilihannya di laporan.
Kurva precision-recall untuk hujan lebat
Untuk data sangat tidak seimbang, ROC/AUC bisa “manis” namun menyesatkan (Bab 3 §3.9). Pilih precision-recall curve:
- Sumbu x: recall (= POD); sumbu y: precision (= 1 - FAR).
- Model ideal: kurva mendekati pojok kanan-atas (recall tinggi, precision tinggi).
- Luas di bawah (AUPRC) lebih informatif daripada AUC untuk kelas langka.
- Baseline kurva PR bukan 0.5 (tidak seperti ROC/AUC): garis acak berada di proporsi kelas positif dalam data (mis. 5% hujan lebat). Model lebih baik daripada menebak jika kurvanya berada di atas garis baseline itu (Gambar 9.1).
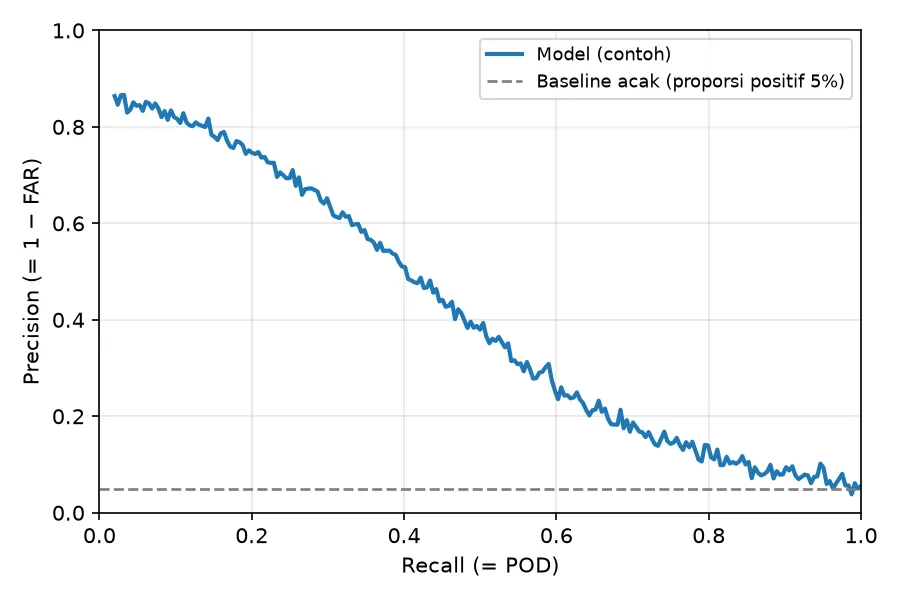
Gambar 9.1: Precision-recall curve untuk deteksi hujan lebat (ilustratif); garis putus-putus menunjukkan baseline acak (proporsi kelas positif).
Visualisasi semacam Gambar 9.1 melengkapi Tabel 9.3 dan menjadi
argumen visual mengapa threshold tertentu dipilih. Untuk data Anda sendiri, hitung
kurva dengan sklearn.metrics.precision_recall_curve:
Kode 9.4 - Menggambar kurva precision-recall dengan baseline acak.
from sklearn.metrics import precision_recall_curve
import matplotlib.pyplot as plt

prec, rec, _ = precision_recall_curve(y_true, prob)  # y_true: label biner (lebat)
base = float(y_true.mean())                          # baseline = proporsi kelas positif

fig, ax = plt.subplots(figsize=(6, 4))
ax.plot(rec, prec, lw=2, label="Model")
ax.axhline(base, color="gray", ls="--", lw=1.3,
           label=f"Baseline acak (proporsi positif {base:.0%})")
ax.set_xlabel("Recall (= POD)")
ax.set_ylabel("Precision (= 1 - FAR)")
ax.set_xlim(0, 1); ax.set_ylim(0, 1)
ax.grid(alpha=0.3)
ax.legend(loc="best")
plt.tight_layout()
plt.show()
Persamaan yang dipakai (dari Tabel 5.3 Bab 5, pedoman WMO [7]):
Persamaan (9.1) memberi tiga sudut pandang yang saling melengkapi. Contoh membaca hasil:
Tabel 9.3: Contoh verifikasi threshold untuk menjelaskan trade-off (ilustratif).
| Threshold | POD | FAR | CSI |
|---|---|---|---|
| 0,2 | 0.82 | 0.55 | 0.40 |
| 0,5 | 0.58 | 0.34 | 0.43 |
| 0,8 | 0.31 | 0.20 | 0.27 |
Membaca Tabel 9.3: threshold rendah (0,2) menangkap banyak kejadian (POD 0,82) tetapi banyak alarm palsu (FAR 0,55); threshold tinggi (0,8) sebaliknya. Titik terbaik bukanlah “yang CSI tertinggi” semata - melainkan yang paling sesuai konsekuensi: untuk peringatan dini, POD tinggi (dengan FAR wajar) sering dipilih; untuk kebijakan evakuasi yang mahal, FAR rendah lebih penting.
9.5 Baseline, Walk-Forward, dan Arsitektur
Baseline yang diuji
- Persistence: hujan besok = hujan hari ini. Lemah untuk hujan (banyak nol, berisik) - kalah dari klimatologi pada banyak musim.
- Klimatologi: rata-rata hujan untuk kalender yang sama. Baseline yang kuat untuk hujan harian.
- ARIMA singkat: autoregressive ARIMA(p,d,q) kecil (misal p,q ≤ 2, d ∈ {0,1}); memberi patokan linier [8].
Pilihan ini mengingatkan Bab 7: deep learning harus mengalahkan baseline yang paling kuat (sering klimatologi untuk hujan), bukan sekadar “bekerja”.
Membangun baseline klimatologi yang benar
Klimatologi “cerdas” untuk hujan tidak cukup dengan rata-rata global; gunakan rata-rata per kalender (misal rata-rata hujan tanggal 5 Januari selama semua tahun latih, atau rata-rata per bulan). Dengan begitu baseline sudah menangkap musim. Contoh perhitungan sederhana:
# rata-rata harian per hari ke-n (1..366) dari data latih, lalu ulangi ke test
klim = df_train.groupby(df_train.index.dayofyear)["r_hujan"].mean()
baseline = klim.reindex(df_test.index.dayofyear).values
Jika model GRU Anda tidak mengalahkan climatology-smart ini pada metrik utama, perbaiki fitur atau ganti pendekatan - jangan dibiarkan dan “dilaporkan sebagai selesai”.
Walk-forward
Seperti Bab 8: bagi beberapa tahun menjadi blok tahunan; untuk tiap blok latih hanya data sebelumnya, evaluasi pada blok itu; laporkan rata-rata + rentang. Hujan punya variabilitas antar tahun besar (El Niño/La Niña), jadi rentang antar blok harus dilaporkan - satu angka rata-rata bisa menyesatkan.
Catatan walk-forward: karena fitur punya lag/window, beri purge/embargo di batas train-test (drop beberapa hari pertama blok validasi) untuk menghindari leakage halus. Scaler, baseline, dan hyperparameter di-refit ulang untuk setiap blok latih - tidak sekali untuk seluruh data (Bab 5 §5.5, Bab 6 §6.7). Laporkan jumlah sampel dan jumlah kejadian langka per blok, bukan hanya metrik rata-rata.
Menyusun “kalender eksperimen”
Untuk menghindari hasil yang membingungkan, susun eksperimen secara teratur, misalnya tabel berikut:
| Eksperimen | Fitur | Model | Baseline terbaik | Catatan |
|---|---|---|---|---|
| E1 | lag saja | GRU | klimatologi | dasar |
| E2 | + musiman | GRU | - | lihat dampak musiman |
| E3 | + ENSO/MJO | GRU | - | lihat dampak indeks iklim |
| E4 | E3 + MLP | MLP | - | pembanding non-sekuensial |
Tabel 9.4: Rancangan eksperimen (template yang dipakai di notebook).
Disiplin “satu perubahan per eksperimen” (Bab 5 §5.6) menjaga agar Anda tahu persis apa yang menyebabkan perbedaan POD/CSI, bukan hanya “model jadi lebih baik”.
Arsitektur jaringan
Mengikuti Bab 7-8: GRU multivariate w hari dengan fitur per langkah waktu
((batch, w, f)); lapisan Dense terakhir - regresi: Dense(1) (aktivasi linear) +
loss=mse; klasifikasi biner: Dense(1, activation="sigmoid") +
binary_crossentropy; multi-kelas: Dense(K, activation="softmax") +
sparse_categorical_crossentropy. Untuk klasifikasi
hujan lebat yang jarang terjadi, tambah class_weight (Bab 3 §3.5) agar model tidak
meniru mayoritas.
9.6 Interpretasi Awal: Mengapa Model Bilang Begitu?
Deep learning “kotak hitam” menjadi masalah untuk kepercayaan operasional. Interpretasi global (fitur apa yang paling berpengaruh) dan lokal (mengapa satu prediksi tertentu) dibahas penuh di Bab 10; di sini kita mulai dengan permutation importance pada model yang sudah dilatih (SHAP penuh di Bab 10).
Kode 9.2 - Permutation importance sederhana.
def permutation_importance(model, X, y, n_repeat=10, metric=mae):
    # X: (n_samples, timesteps, n_features) untuk input 3D (GRU/LSTM)
    n_feat = X.shape[2]
    base = metric(y, model.predict(X, verbose=0).ravel())
    imp = {}
    for j in range(n_feat):
        scores = []
        for _ in range(n_repeat):
            Xp = X.copy()
            perm = np.random.permutation(Xp.shape[0])
            Xp[:, :, j] = Xp[perm, :, j]   # acak fitur j di semua timestep
            scores.append(metric(y, model.predict(Xp, verbose=0).ravel()))
        imp[j] = float(np.mean(scores) - base)
    return imp
Catatan implementasi: kode 9.2 acak fitur di semua timestep (input 3D). Untuk MLP
2D (n, f), sesuaikan indeks menjadi X.shape[1] dan acak Xp[:, j]. Untuk
klasifikasi, gunakan metrik langka (AUPRC, log-loss, atau CSI), bukan MAE.
Prinsip: jika mengacak satu fitur membuat error naik banyak, fitur itu penting. Kewaspadaan: untuk fitur yang saling berkorelasi, permutation importance bisa menyesatkan (mengacak satu membuat yang lain “kehilangan konteks”). Bab 10 memakai SHAP untuk penjelasan yang lebih stabil dan disertai kewaspadaan penggunaannya.
Hasil yang “masuk akal” untuk hujan Indonesia biasanya:
hujan_t1,hujan_t2penting (persistensi kondisi basah).- Fitur musiman (
mus_sin/cos) tinggi (pola monsun). rmm1,rmm2membantu di beberapa lokasi (osilasi 30-60 hari).
Jika satu fitur yang secara fisis seharusnya penting ternyata tidak muncul, bisa jadi data/fitur kurang bersih - bahan perbaikan (Bab 6).
Kewaspadaan interpretasi
Interpretasi global bersifat deskriptif, bukan kausal: fitur “penting” tidak berarti
“penyebab”. Contoh: hujan_t1 penting bukan karena hari hujan menyebabkan hari hujan
berikutnya, melainkan karena ia berkorelasi kuat dengan kondisi basah yang berlanjut.
Demikian pula untuk ENSO/MJO: pentingnya menunjukkan asosiasi, bukan mekanisme.
Selain itu, model yang dilatih dengan fitur berkorelasi (misal suhu dan mus_sin)
bisa membagi “kredit” di antara keduanya secara acak; jangan menafsirkan pentingnya
satu-per-satu sebagai pengaruh terisolasi. Untuk klaim kausal, perlakukan dengan sangat
hati-hati (Bab 10 membahas etika & batas interpretasi).
Melakukan interpretasi ini sejak tahap kajian (bukan setelah produksi) membantu menemukan masalah data lebih awal. Bab 10 memperluas ke interpretasi lokal per prediksi dan penggunaannya untuk menilai kepercayaan praktisi.
9.7 Tabel Verifikasi per Kategori
Bagian laporan yang paling berguna untuk praktisi: contingency table dirangkum menjadi tabel ringkas.
Kode 9.3 - Tabel ringkas verifikasi per kategori intensitas.
import pandas as pd

def tabel_kategori(y_true, y_pred):
    return pd.crosstab(pd.Series(y_true, name="aktual"),
                       pd.Series(y_pred, name="prediksi"))
pd.crosstab memberi counts saja; untuk CSI/POD/FAR per kategori, hitung per
kategori secara one-vs-rest (kelas k positif, semua lain negatif) - misal dengan
ulangi fungsi verifikasi (Kode 9.1) untuk setiap k.
Laporkan untuk masing-masing kategori (0, 1, 2) nilai CSI/POD/FAR secara terpisah -
perilaku model pada hujan lebat (langka) sering jauh lebih buruk daripada pada hari
kering, dan ini penting diketahui pengguna (Bab 5). Contoh kerja penuh (termasuk
threshold, probabilitas, dan crosstab) tersedia di notebook ch-09-08_studi_kasus_curah_hujan_terbuka.ipynb.
Tabel 9.5: Contoh ringkas verifikasi per kategori (ilustratif).
| Kategori | POD | FAR | CSI | Catatan |
|---|---|---|---|---|
| Tidak hujan / ringan (< 20) | 0.90 | 0.15 | 0.78 | baik, kelas mayoritas |
| Sedang (20 - <50) | 0.45 | 0.40 | 0.32 | perlu perbaikan |
| Lebat / sangat lebat (≥ 50) | 0.20 | 0.55 | 0.15 | sulit, kelas langka |
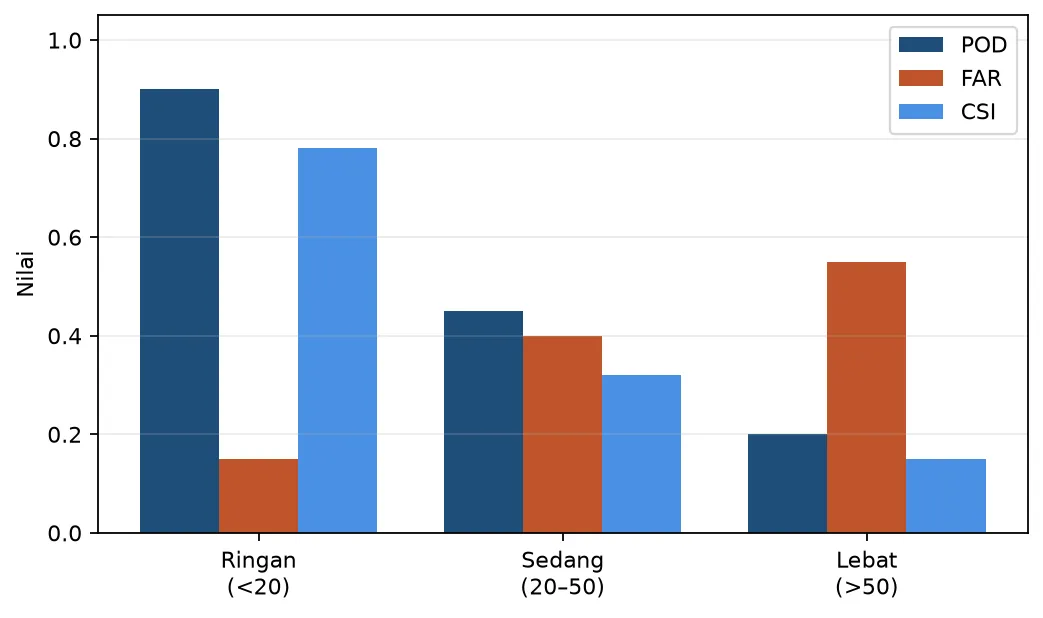
Gambar 9.2: Verifikasi per kategori intensitas (ilustratif).
Tabel 9.5 dan Gambar 9.2 menyingkap hal menarik: model “bagus” pada hari kering (POD tinggi, FAR rendah) justru paling lemah pada kejadian yang paling penting (lebat). Ini hasil yang layak dilaporkan apa adanya, bukan disembunyikan. Seluruh eksperimen bab ini berjalan di atas TensorFlow [9].
Apa yang harus dilaporkan (dan apa yang tidak)
Laporan studi kasus yang jujur biasanya berisi:
- Konteks & data - lokasi/lintasan, rentang, sumber, lisensi, jumlah contoh.
- Metode - fitur, window, arsitektur, baseline, skema walk-forward.
- Hasil - MAE/RMSE (regresi), CSI/POD/FAR per threshold & kategori, plus rentang antar blok.
- Threshold yang dipilih & alasannya - konteks operasional.
- Interpretasi - fitur penting (dengan kewaspadaan), error per musim.
- Keterbatasan - data contoh vs nyata, satu/dua titik lokasi, tanpa optimasi menyeluruh.
Yang tidak perlu dilaporkan: klaim “akurasi 99%” tanpa metrik langka, angka tanpa baseline, atau kesimpulan kausal dari korelasi. Format ini langsung dipakai kembali di Bab 10 untuk keputusan produksi.
9.8 Latihan
Soal konsep
- Mengapa klimatologi sering menjadi baseline yang menantang untuk hujan harian? Bagaimana cara menaikkannya?
- Jelaskan trade-off POD-FAR: untuk mana Anda memilih threshold rendah pada konteks peringatan dini, dan untuk mana threshold tinggi pada konteks evakuasi mahal?
- Mengapa metrik per kategori (Tabel 9.5) lebih informatif daripada satu akurasi global?
- Apa risiko menafsirkan permutation importance pada fitur berkorelasi?
- Kapan Anda lebih memercayai klimatologi daripada model GRU yang CSI-nya sedikit lebih tinggi?
Jawaban singkat yang diharapkan (untuk soal konsep)
- Hujan harian didominasi banyak nol & variabel musim; klimatologi “cerdas” (per kalender) sudah menangkap musim - patokan yang sulit dikalahkan model yang hanya menebak persisten.
- Peringatan dini → threshold rendah (POD tinggi, toleransi false alarm); evakuasi mahal → threshold tinggi (FAR rendah), meski banyak kejadian terlewat.
- Hari kering mendominasi; akurasi global hampir 100% tanpa gagal menangkap lebat yang justru penting - metrik per kategori mengungkap distribusi kinerja.
- Fitur berkorelasi membagi “kredit” di antara mereka; mengacak satu mengurangi konteks yang lain → angka menyesatkan.
- Tidak langsung; cek rentang antar blok walk-forward & konteks operasional sebelum memutuskan - model harus mengalahkan baseline secara konsisten, bukan sekali.
Latihan praktik (notebook ch-09-08_studi_kasus_curah_hujan_terbuka.ipynb)
- Gunakan data contoh harian satu titik lokasi; bangun fitur (Tabel 9.1).
- Regresi: latih GRU dengan transformasi
log1p; hitung MAE/RMSE; bandingkan dengan persistence & klimatologi pada walk-forward 3 blok. - Klasifikasi biner lebat vs tidak: evaluasi threshold 0,2/0,5/0,8 (Tabel 9.3); tetapkan threshold berdasarkan skenario (peringatan dini vs evakuasi) dan jelaskan.
- Klasifikasi multi-kelas intensitas: buat crosstab (Kode 9.3) dan hitung CSI/POD/FAR per kategori (Tabel 9.5).
- Tambahkan indeks MJO/ENSO; bandingkan CSI lebat dengan dan tanpa fitur tersebut.
- (Proyek mini) Susun laporan satu halaman seperti Bab 8: konteks, data, metode, tabel hasil, threshold terpilih, interpretasi & keterbatasan.
Ringkasan
- Prediksi hujan berdampak langsung pada masyarakat; kejujuran framing & metrik wajib.
- Data: titik grid CHIRPS (target + lag), ERA5/ERA5-Land (regional), ENSO/MJO (indeks iklim); pola barat vs timur Indonesia berbeda dan perlu dilatih ulang per lokasi.
- Dua lintasan: regresi (mm,
log1p, MAE/RMSE) dan klasifikasi (kategori, CSI/POD/FAR); menangani imbalance dengan class_weight & threshold. - Threshold bukan 0,5 tetap - atur sesuai biaya kesalahan; gunakan precision-recall untuk data langka (Tabel 9.3).
- Baseline kuat: klimatologi “cerdas” per kalender (juga persistence & ARIMA); deep learning harus mengalahkannya secara konsisten (Tabel 9.4).
- Walk-forward multi-blok; laporkan rentang, bukan hanya rata-rata.
- Interpretasi dimulai dari permutation importance (deskriptif, bukan kausal; SHAP di Bab 10).
- Laporkan verifikasi per kategori - kejadian langka paling penting & paling sulit (Tabel 9.5), lengkap dengan keterbatasan.
References
- C. Funk et al., “The climate hazards infrared precipitation with stations - a new environmental record for monitoring extremes,” Scientific Data, vol. 2, 150066, 2015, doi: 10.1038/sdata.2015.66. Data diunduh dari https://data.chc.ucsb.edu/products/CHIRPS-2.0/ (Accessed: Sep. 2026).
- Copernicus Climate Change Service (C3S), “ERA5: fifth generation ECMWF atmospheric reanalysis of the global climate,” Copernicus Climate Data Store, [Online]. Available: https://cds.climate.copernicus.eu (Accessed: Sep. 2026).
- H. Hersbach et al., “The ERA5 global reanalysis,” Quarterly Journal of the Royal Meteorological Society, vol. 146, no. 730, pp. 1999-2049, 2020, doi: 10.1002/qj.3803.
- M. C. Wheeler and H. H. Hendon, “An all-season real-time multivariate MJO index: development of an index for monitoring and prediction,” Monthly Weather Review, vol. 132, no. 8, pp. 1917-1932, 2004, doi: 10.1175/1520-0493(2004)132<1917:AARMMI>2.0.CO;2.
- K. Wolter and M. S. Timlin, “Monitoring ENSO in COADS with a seasonally adjusted principal component index,” in Proc. 17th Climate Diagnostics Workshop, 1993, pp. 52-57.
- NOAA Physical Sciences Laboratory, “Nino3.4 SST index,” [Online]. Available: https://psl.noaa.gov/data/timeseries/monthly/NINO34/ (Accessed: Sep. 2026).
- World Meteorological Organization, “WMO guidelines on the verification of operational forecasts,” WMO-No. 1214, Geneva, Switzerland, 2018.
- R. J. Hyndman and G. Athanasopoulos, Forecasting: Principles and Practice, 3rd ed. Melbourne, Australia: OTexts, 2021. [Online]. Available: https://otexts.com/fpp3/
- M. Abadi et al., “TensorFlow: Large-scale machine learning on heterogeneous systems,” 2016. [Online]. Available: https://arxiv.org/abs/1603.04467